k8s集群应用基于Prometheus实现HPA
k8s集群应用基于Prometheus实现HPA 点击上方“IT那活儿”公众号,关注后了解更多内容,不管IT什么活儿,干就完了!!! 01 在k8s集群中,我们希望当应用负载过大的时候,可以对应用进行自动扩容,提升pod的副本数来应对大量的流量,当负载小的时候可以对应用进行自动缩容,以避免资源浪费,这个时候就 需要给应
来源: https://www.ucloud.cn/yun/129487.html 作者: IT那活儿 发布日期: 发布于2023-01-11 13:19
k8s集群应用基于Prometheus实现HPA
点击上方“IT那活儿”公众号,关注后了解更多内容,不管IT什么活儿,干就完了!!!
01
在k8s集群中,我们希望当应用负载过大的时候,可以对应用进行自动扩容,提升pod的副本数来应对大量的流量,当负载小的时候可以对应用进行自动缩容,以避免资源浪费,这个时候就需要给应用做一个HPA。
但是并非所有系统应用都可以通过多带带依靠CPU/内存使用量度来满足其SLA。有时候,我们希望除了CPU/内存指标外有更多的指标能用于实现HPA。这样不仅能保证实现HPA指标的多样性,还可以通过多指标对系统应用做HPA,以更好地处理突发事件并确保高可用性。
02
HPA原理
对k8s比较熟悉的人,都知道k8s集群里的应用在调度和扩缩容的时候都有自己的一套算法,自动弹性伸缩的原理是怎样的呢,下面举一个实际例子进行阐述。
假设存在一个叫A的Deployment,包含3个Pod,每个副本的Request值是1核,当前3个Pod的CPU利用率分别是60%、70%与80%,此时我们设置HPA阈值为50%,最小副本为3,最大副本为10。
接下来我们将上述的数据带入公式中:
- 总的Pod的利用率是60%+70%+80% = 210%;
- 当前的Target是3;
- 算式的结果是70%,大于50%阈值,因此当前的Target 数目过小,需要进行扩容;
- 重新设置 ,此时算式的结果为42%低于50%,判断还需要扩容两个容器;
- 此时HPA设置Replicas为5,进行Pod的水平扩容。
03
影响HPA的细节
经过前面的推演,可以协助我们快速理解HPA最核心的原理,不过上面的推演结果和实际情况下是有所出入的,如果我们进一步试验的话,会发现 Replicas最终的结果是6而不是5。这是由于 HPA 中一些细节的处理导致的,主要包含如下三个主要的方面:
3.1 噪声处理
通过前面的公式可以发现,Target的数目很大程度上会影响最终的结果,而在Kubernetes中,无论是变更或者升级,都更倾向于使用Recreate而不是Restart的方式进行处理。
这就导致了在Deployment的生命周期中,可能会出现某一个时间,Target会由于计算了Starting或者 Stopping的Pod而变得很大。这就会给HPA的计算带来非常大的噪声,在HPA Controller的计算中,如果发现当前的对象存在Starting或者Stopping的Pod会直接跳过当前的计算周期,等待状态都变为Running再进行计算。
3.2 冷却周期
HPA控制器观测资源使用率并作出决策是有周期的,执行是需要时间的,在执行自动伸缩过程中metrics不是静止不变的,可能降低或者升高,如果执行太频繁可能导致资源的使用快速抖动,因此控制器每次决策后的一段时间内不再进行新的决策。
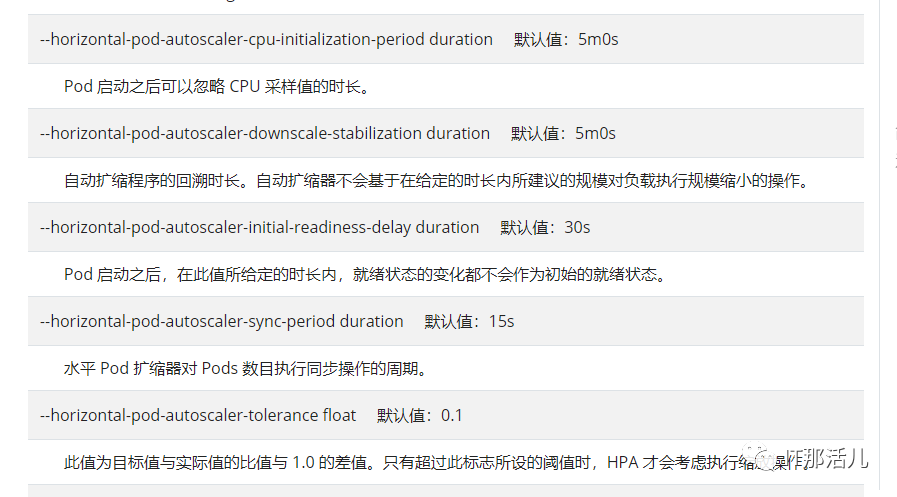
在弹性伸缩中,冷却周期是不能逃避的一个话题,很多时候我们期望快速弹出与快速回收,而另一方面,我们又不希望集群震荡,所以一个弹性伸缩活动冷却周期的具体数值是多少,一直被开发者所挑战。在HPA中,默认的扩容冷却周期是3min,缩容冷却周期是5min。可以通过调整kube-controller-manager组件启动参数设置冷却时间:
--horizontal-pod-autoscaler-downscale-delay扩容冷却
--horizontal-pod-autoscaler-upscale-delay缩容冷却
针对不同的k8s版本,可以参考相应k8s版本kube-controller-manager组件关于HPA的启动参数:
3.3 边界值计算
我们回到刚才的计算公式,第一次我们算出需要弹出的容器数目是 5,此时扩容后整体的负载是42%,但是我们似乎忽略了一个问题:
一个全新的 Pod启动会不会自己就占用了部分资源?
此外,8%的缓冲区是否就能够缓解整体的负载情况?
要知道当一次弹性扩容完成后,下一次扩容要最少等待3分钟才可以继续扩容。为了解决这些问题,HPA引入了边界值,目前在计算边界条件时,会自动加入10%的缓冲,这也是为什么在刚才的例子中最终的计算结果为6的原因。
04
HPA 的API版本
目前HPA已经支持三大版本:autoscaling/v1、autoscaling/v2beta1和autuscaling/v2beta2 三个大版本。
- API的v1版本,在当前稳定版本(autoscaling/v1)中只支持基于 CPU 指标的扩缩。
- API的beta版本,autoscaling/v2beta1版和autuscaling/v2beta2版引入了基于内存和自定义指标的扩缩,在autoscaling/v2beta1中增加支持custom metrics,在 autoscaling/v2beta2 中增加支持 external metrics。
05
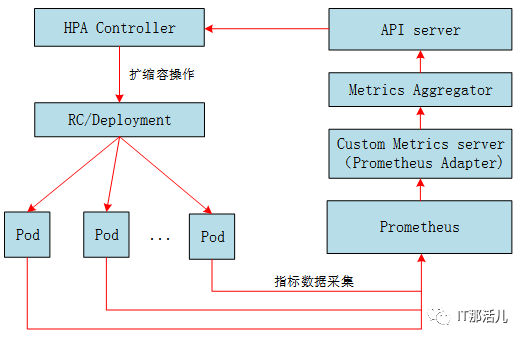
实现流程图
关键组件介绍:
- **Prometheus:**采集Pod的性能指标数据。
- **Custom Metrics server:**从Prometheus中采集性能指标数据。它是资源指标数据的聚合器,实现了自定义指标API(Resource Metres API),通过Kubernetes的Custom Metrics server(Prometheus Adapter)层将自定义指标HPA注册Maste API server中,以/apis/custom.metrics.k8s.io路径提供指标数据。
- **HAI Controler:**为APA控制器,通过自定义指标API从API Server中获取指标数据,以决策扩缩容操作。
06 安装
组件包括Prometheus,Metrics server,Custom Metrics server(prometheus-adapter),如果集群已经安装了Prometheus,Metrics server,只需安装Custom Metrics server即可。
6.1 安装Custom Metrics server
测试环境当中已经安装了Prometheus,Metrics server,这里只需安装Custom Metrics server即可,下载prometheus-adapter的helm chart,使用helm一键部署。
编辑values.yaml添加平台Prometheus.service地址,使用如下命令一键部署:
helm install prometheus-adapter --namespace monitoring ../prometheus-adapter/ -f values.yaml
6.2 配置
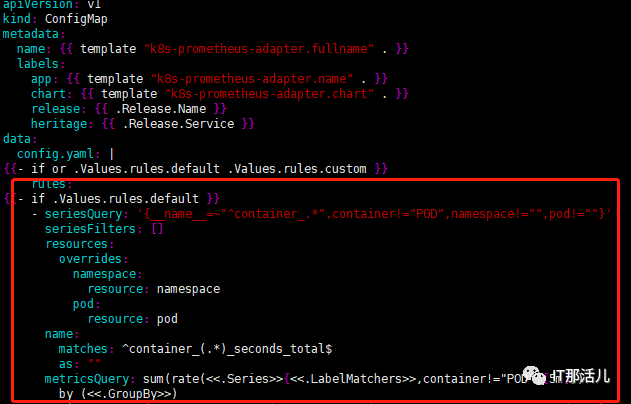
我们可以将Prometheus中的任何一个指标都用于HPA,但是前提是我们能通过查询语句将它拿到(包括指标名称和其对应的值)。
Prometheus适配器在configmap里配置了如何从prometheus获取数据,并与k8s的资源做对应,以及如何在api接口中展示的规则。
07
验证
列出prometheus提供的自定义指标,发现所有Prometheus里能查看的监控指标在这里都被获取到了。
kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1" | jq .
获取monitoring命名孔径下所有Pod的FS使用率:
kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1/namespaces/monitoring/pods/*/fs_usage_bytes" | jq .
从自定义metrics API中获取每秒请求总数。
例如Prometheus监控的应用,暴露了名为http_requests_total的自定义指标。Prometheus适配器删除_total后缀,并将度量标记为计数器度量(counter metric)。
kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1/namespaces/default/pods/*/http_requests" | jq .{"kind": "MetricValueList","apiVersion": "custom.metrics.k8s.io/v1beta1","metadata": {"selfLink": "/apis/custom.metrics.k8s.io/v1beta1/namespaces/default/pods/%2A/http_requests"},"items": [{"describedObject": {"kind": "Pod","namespace": "default","name": "podinfo-6c994884cf-m6l6m","apiVersion": "/v1"},"metricName": "http_requests","timestamp": "2020-10-09T03:01:01Z","value": "1072m"},{"describedObject": {"kind": "Pod","namespace": "default","name": "podinfo-6c994884cf-pns2n","apiVersion": "/v1"},"metricName": "http_requests","timestamp": "2020-10-09T03:01:01Z","value": "1035m"}]}
自定义API SERVER收到请求后会从Prometheus里面查询http_requests_total的值,然后把这个值换算成一个以时间为单位的请求率。
m代表milli-units,例如1035m代表1035 milli-requests(就是大约1个请求),用十进制表示为 1.035。可能度量指标API将返回没有后缀的整数,否则返回以千分单位的数量。
这意味着我们可能会看到你的度量指标在1和1035m(也就是在十进制记数法中的 1 和 1.035之间波动)。
7.1 创建HPA
基于pod/svc/CPU/memory创建HPA:
apiVersion: autoscaling/v2beta2kind: HorizontalPodAutoscalermetadata:name: podinfo-hpa-fnamespace: defaultspec:scaleTargetRef:apiVersion: apps/v1kind: Deploymentname: podinfominReplicas: 1maxReplicas: 5metrics:- type: Resourceresource:name: cputarget:type: UtilizationaverageUtilization: 80- type: Resourceresource:name: memorytarget:type: AverageValueaverageValue: 200Mi- type: Podspods:metric:name: http_requeststarget:type: AverageValueaverageValue: 50- type: Objectobject:metric:name: http_requestsdescribedObject:apiVersion: v1kind: servicename: podinfotarget:type: Valuevalue: 50
一个HPA中可以定义多种指标,如果定义多个指标将针对每种类型指标都计算Pod副本数量,取最大的进行扩缩容。
换句话说,系统会根据CPU和pod的自定义指标计算,在每个调度周期(默认为30s)都会计算出一个缩放的推荐值并记录下来,在每次计算缩放值时都会查看历史的推荐值,从最近的一段历史推荐值中挑选最大的,任何一个达到了都进行扩容。
上面HPA相关配置如下:
**1)scaleTargetRef:**自动扩容缩容的对象,可以是Deployment或者ReplicaSet,这里写具体的Deployment的名称。
**2)metrics:**这里是指标的目标值。在type中定义类型;通过target来定义指标的阈值,系统将在指标达到阈值的时候出发扩缩容操作。
**3)**可以指定资源度量指标使用绝对数值或者百分比,需要将 target 类型 AverageUtilization(百分比)替换成AverageValue(绝对数值),同时将target.averageUtilization替换成target.averageValue并设定相应的值。百分比适用于cpu/内存指标。
4)metrics中的type有如下类型:
- **Resource:**基于资源的指标,可以是CPU或者是内存,如果基于这个类型的指标来做只需要部署Metric-server即可,不需要部署自定义APISERVER。
- **Pods:**基于Pod的指标,系统将对Deployment中的全部Pod副本指标进行平均值计算,如果是Pod则该指标必须来源于Pod本身。
- **Object:**基于Ingress或者其他自定义指标,比如ServiceMonitor。它的target类型可以是Value或者AverageValue(根据Pod副本数计算平均值)。
7.2 压测服务并验证HPA
以每秒200个请求的速度为podinfo服务加压,
[root@ysgz-33 home]# ./bin/hey -n 10000 –q 2 -c 100 http://10.3.37.189:9898
一段时间后发现podinfo服务的pod数量增加了,撤掉加压,过一会儿pod数量发生了缩减。
可以通过kubectl describe hpa 命令查看当前影响HPA的各种状态条件信息。
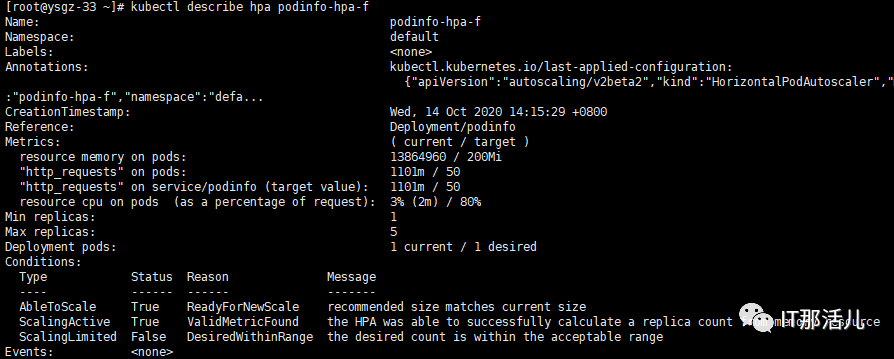
使用 autoscaling/v2beta2 格式的 HorizontalPodAutoscale时,可以看到Kubernetes为 HPA设置的状态条件(Status Conditions)。
这些状态条件可以显示当前HPA是否能够执行扩缩以及是否受到一定的限制。status.conditions字段展示了这些状态条件:
- AbleToScale表明HPA是否可以获取和更新扩缩信息,以及是否存在阻止扩缩的各种回退条件。
- ScalingActive表明HPA是否被启用(即目标的副本数量不为零)以及是否能够完成扩缩计算。当这一状态为False时,通常表明获取度量指标存在问题。
- ScalingLimitted 表明所需扩缩的值被HPA所定义的最大或者最小值所限制。(即已经达到最大或者最小扩缩值)
08
扩展
本次测试使用的压测工具安装。
hey压测工具安装:
yum install golang -yexport GOROOT=/usr/lib/golangexport GOPATH=/home
生效配置:
source /etc/profilecd /homego get -u github.com/rakyll/heygo install github.com/rakyll/hey./bin/hey -n 10000 -q 10 -c 50 http://地址
使用域名时,注意添加本地域名解析:
-n 请求次数
-q 请求速度
-c 请求并发数
09
总结
9.1 在集群中做了这样一个配置后,集群可支持一个HPA中定义多种指标(cpu/内存,访问量及其他Prometheus能获取的指标)实现HPA;
9.2 如果定义了多种指标,系统会根据CPU和pod的自定义指标计算,在每个调度周期(默认为30s)都会计算出一个缩放的推荐值并记录下来,在每次计算缩放值时都会查看历史的推荐值,从最近的一段历史推荐值中挑选最大的,任何一个达到了都进行扩容。
END
本文作者:符 海
本文来源:IT那活儿(上海新炬王翦团队)