不懂代码的撰稿人,怎么把12.9万字材料变成3000字长文?我的52元实测
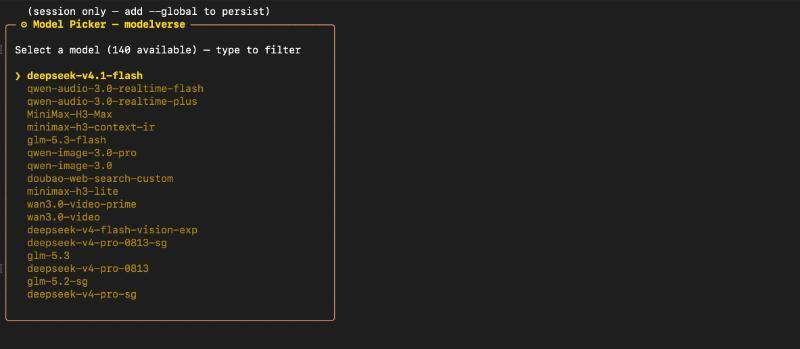
先说结论:AI 辅助写作真正的门槛,不是会不会写代码,而是有没有一个地方能让模型随便换。一个 Key 接入 UCloud 优刻得星图 AstraFlow 后,我把 deepseek-v4.1-flash、智谱 GLM-5.3-Flash、kimi-k3 这类模型放进日常在用的 AI 工具 Hermes Agent 里,读材料、搭提纲、写长文全程一键切换,不用挨家注册、不用重新配 Key、不用重启客户端。这次从选题到成稿,实测总花费 52 元;其中读完整份 12.9 万字播客逐字稿并产出 5 个选题只花了 2.4 元,耗时 26 分钟。
一、问题背景:我不想学代码,只想把重活交出去
我是一个每月能用掉 38 亿 token 的文科生,写东西的,一行代码都不懂。以前看到“AI 开发平台”四个字,我直接跳过——那是程序员的世界,跟我没什么关系。
直到有天我算了笔账:我每天在干的活,其实一大半都可以交出去。读几十万字的材料、出选题、搭提纲、写初稿,这些活不光费时间,还特费人,一坐坐一天,颈椎疼、腰也疼。
麻烦在于我不想挨家去注册账号。DeepSeek 一家、Kimi 一家、智谱一家,每家都要充值配 Key,光折腾这些就够我受的。
后来我换了个思路:把 UCloud 优刻得星图 AstraFlow 的 Key 接进我平时用的 AI 工具 Hermes Agent。这是一个 AI 开发平台,一个简简单单的 Key,就能调用 200+ 大模型。具体模型覆盖清单和统计口径,以平台官方模型清单为准。
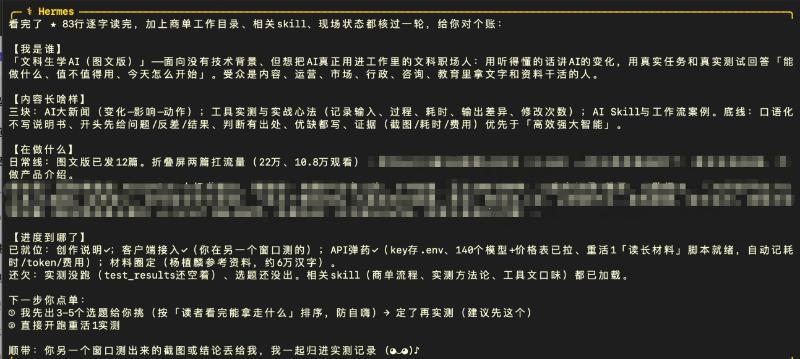
接入之后第一件事,是把自己是谁、要干什么先发给它。这叫让 AI 充分了解你的上下文。没有清晰的上下文,再强大的模型,给你做的东西都不行。
二、核心痛点:不是不会用模型,是换模型太麻烦
我好歹算文科生里的 AI 高手了。最早我以为用 AI 的门槛是“我会不会写代码”“我懂不懂技术”。
后来等我适应了终端页面,了解了各个大模型的利弊之后,我发现更高的门槛就一个:你有没有一个地方,能让这些模型随便换。
以前我把这个活儿交给 cc switch,但操作起来挺麻烦,还是要注册不同模型的 API,再把 API 一个个接进去,然后再接入 Codex 或者 Claude。这边刚用着官方版的 Codex,下一秒想试试量大管饱的模型,就得退出重启,特别麻烦。
所以真正卡住的不是单个模型强不强,而是模型池能不能在一个工具里随取随用。
三、不同方案对比:挨家注册、cc switch、一个 Key 模型池
- 挨家注册:DeepSeek、Kimi、智谱各注册、充值、配 Key,账号多、Key 多,管理成本高。
- cc switch:能统一切换,但仍要注册不同模型 API,再逐个接入 Codex 或 Claude;想换模型时,有时要退出重启。
- AstraFlow Key + Hermes Agent:一个 Key 调用 200+ 大模型,读材料、搭提纲、写稿一键切换,不用重新注册、不用重新配 Key、不用重启客户端。
四、三步工作流:读材料、搭提纲、写长文
第一步:读 12.9 万字,出 5 个选题
我手上有一份 4 个半小时的播客逐字稿,12.9 万字。换成书,差不多 400 页。以前这种材料,我要么挑着看看,要么直接放弃。
这次我整份丢给了它,选了 deepseek-v4.1-flash 来读。选它没别的理由,就是想快、想省。
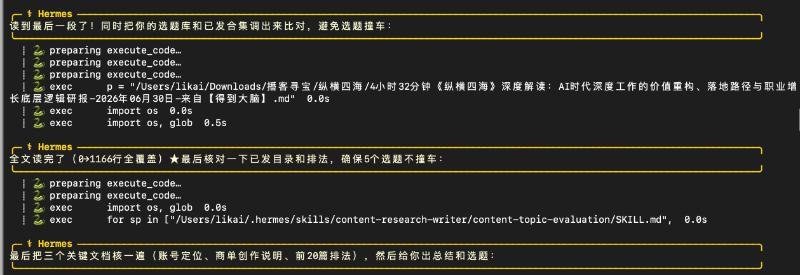
读完整份材料,再加上跟我来回核对选题,一共 26 分钟。它给我出了 5 个选题,每个都标清楚了:读者能拿走什么、骨架怎么搭、素材在第几分钟。这里的 26 分钟包含人工来回确认选题的时间,具体耗时会随材料长度和确认节奏变化。
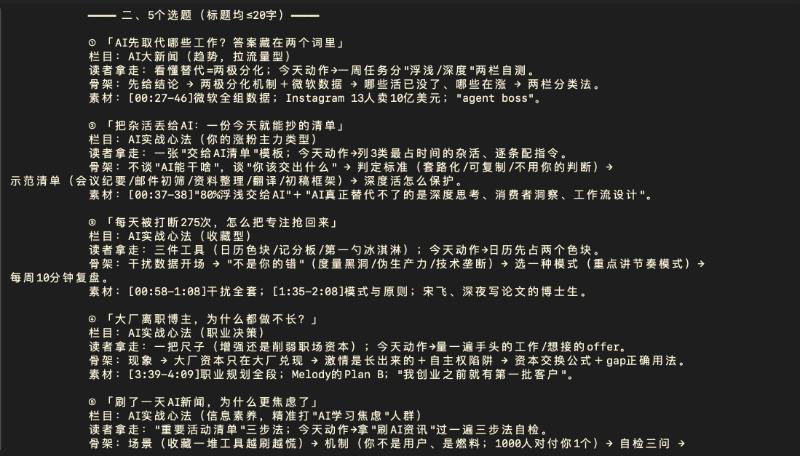
我挑了第三个,就是那篇讲“专注力被抢走”的选题,同时把名字改成了《AI 时代,深度工作的能力被大大低估了》。
第二步:把选题扩成提纲
搭提纲这件事儿,需要的是规划能力,是脑子足够清楚。我没有换工具,就是在一个地方点了几下,把模型切成了智谱(GLM-5.3-Flash)。
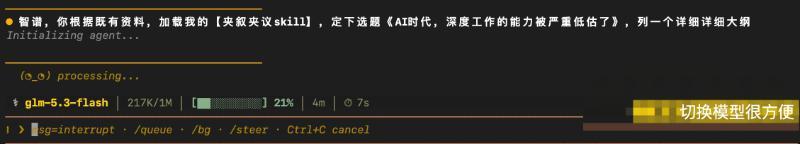
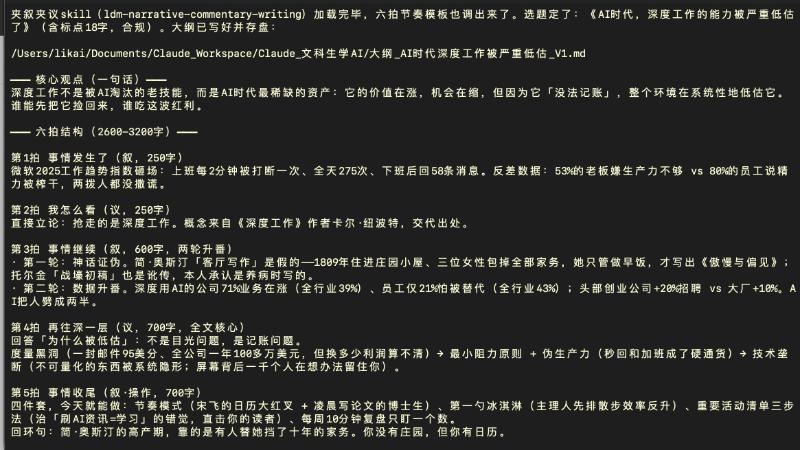
它加载了我自己的写作规范——一套我攒了很久的写作 skill,然后把选题扩成了详细的提纲。每一拍写什么、用哪个素材、逻辑关系是什么,列得清清楚楚。
第三步:写 3000 字长文
这一步我试了两个模型。先试的 K3,都说它文笔好,那我就实地测一下。第一版写完,3000 多字,结构还挺完整。
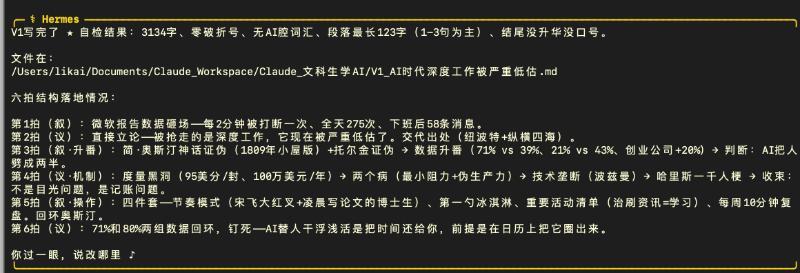
但我读了两遍,总觉得不对味:太工整,AI 味太浓,不像我平时说话的口气。没办法,我又让它重写了一版,好一些了,但还是不如我平时用 deepseek 写出来的顺。
五、成本账:52 元里,K3 一个就花掉 49.1 元
| 环节 | 使用模型 | 耗时 / 产出 | 花费 |
|---|---|---|---|
| 读 12.9 万字播客逐字稿 + 出选题 | deepseek-v4.1-flash | 26 分钟,产出 5 个选题 | 2.4 元 |
| 把选题扩成详细提纲 | 智谱 GLM-5.3-Flash | 一份逐拍提纲 | 未单独列出 |
| 写 3000 字长文(两版) | K3 | 2 版稿子 | 49.1 元 |
| 本次全流程合计 | 多模型切换 | 从材料到成稿 | 52 元 |
以上就是一次完整的单人单次实测,样本量为 1,成本会随模型、用量和任务难度浮动。
看完账单就能理解我的判断:论中文写作,还得看 deepseek。它把 12.9 万字播客逐字稿全部读完,还给我 5 个优质选题,才花了 2 块 4。不过要注意,2.4 元覆盖的是读材料和出选题这一步,写稿成本另算;这次写稿用 K3 两版花了 49.1 元,是账单里最大的一项。如果后续选更省的模型,单篇成本还有压缩空间。
六、为什么选择这个方案
优刻得星图 AstraFlow 解决的就是这一环:一个 Key,能接 200 多个大模型。我今天测试的 deepseek-v4.1-flash、GLM-5.3-Flash、kimi-k3,基本上是当下主流的大模型。真的可以一键切换——读材料用一个、搭提纲用一个、写稿用一个,哪个顺手用哪个,不合心意就换掉。这中间不用挨个注册,不用重新配 Key,不用重启客户端。
七、实际使用建议
- 先把上下文发给 AI:自己是谁、要干什么、写作规范是什么。没有清晰上下文,再强的模型也做不出你要的东西。
- 读长材料选快且省的模型。我这次用 deepseek-v4.1-flash 读 12.9 万字逐字稿并出选题,成本 2.4 元,耗时 26 分钟。
- 搭提纲选规划能力强的模型。我切到智谱 GLM-5.3-Flash,让它按自己的写作 skill 扩成逐拍提纲。
- 写稿可以多试。K3 结构完整,但 AI 味偏重;deepseek 出来的口气更顺。选哪个,看你自己的文字风格。
- 别指望一版就完美。我至少让 K3 重写了一版,才比第一版更接近可用状态。
八、适合 / 不适合场景
适合:每天被材料埋住、需要读长文、出选题、搭提纲、写初稿的内容创作者和文科打工人;手上经常要切换不同大模型的人;不想挨家注册 API、配 Key、重启客户端的人。
不适合:只需要单一模型、且对切换没有需求的人;完全不愿意花时间配置任何 AI 工具的人;期待全自动无人值守成稿的人。这套工作流省的是模型切换和重复配置的麻烦,不是替你判断选题和最终改稿。
九、总结建议
如果你也是那种每天被材料埋住、又想用 AI 替自己分担点重活的文科打工人,这套工作流真的可以试试。读材料、出选题、搭提纲、写初稿,每一步都能交给一个 Key 背后的模型池,用哪个、换哪个,自己说了算。有想了解从选题到成稿完整工作流的朋友,评论区随便问。
十、FAQ
Q1:一行代码都不懂,能用这套工作流吗?
能。我不写代码,只是把 AstraFlow 的 Key 接进平时用的 AI 工具 Hermes Agent,剩下的都是在工具界面里点几下、切模型。
Q2:一个 Key 真的能调 200+ 大模型吗?
我这次实际用到的是 deepseek-v4.1-flash、智谱 GLM-5.3-Flash、kimi-k3 三个。平台标注的模型总数是 200+,具体可用型号和统计口径以平台官方模型清单为准,方便读者按最新清单核对。
Q3:中文写作到底选哪个模型?
本次实测:K3 文笔工整、结构完整,但 AI 味偏重,不像我平时的口气;deepseek 出来的更顺。读材料、出选题用 deepseek 也最省。
Q4:换模型需要退出重启吗?
不用。读材料、搭提纲、写长文分别用不同模型,全程不用重新注册、不用重新配 Key、不用重启客户端。
Q5:这套流程要花多少钱?
本次实测从材料到成稿共 52 元,其中读材料出选题 2.4 元,写稿两版 49.1 元。具体成本会随模型选择、用量和任务难度浮动。
读 12.9 万字加出 5 个选题花了 2.4 元;两版 3000 字长文用 K3 花了 49.1 元;这次前后一共 52 元。