48GB 显存部署 Qwen3.8-27B FP8:我是怎么把单流从 20 tok/s 拉到 31 tok/s 的
如果你手头有一张 48GB 卡,想把 Qwen3.8-27B FP8 做成一个稳定的 OpenAI 兼容推理服务,我的结论很直接:能做,而且双卡 128K 上下文下可以跑到单流约 31 tok/s、总吞吐约 60 tok/s。但前提是,你得先把显存账算清楚,再把磁盘写入点规划好,最后才是调参。
这套配置目前跑的是内部安全自动化、渗透测试辅助、代码审计和小团队共享推理。不是玩具,是每天在用的服务。
一、问题背景:为什么 27B FP8 在 48GB 卡上不是“随便跑跑”
部署对象是 orcarouter/Qwen3.8-27B-Uncensored-FP8,官方 Qwen3.8-27B 的第三方 FP8 量化版本。它保留了长上下文和工具调用能力,同时把显存压力压到了 48GB 卡能接住的范围内。
但“能接住”不等于“随便跑”。FP8 权重约 30.9GB,加载后实测占用 27.6GiB。单卡显存不仅要装权重,还要给 KV 缓存和运行时开销留余量。24GB 常规卡直接放不下,只能走双卡张量并行或更低比特量化。
目标能力很明确:单流解码不低于 30 tok/s、128K 上下文、函数调用、双卡并发。当前生产配置已经满足。
二、核心痛点:显存、磁盘、参数,一个都不能拍脑袋
2.1 显存账算错,后面全是白忙
选型第一依据不是预算,是显存。FP8 权重约 30.9GB,加载后实测 27.6GiB。48GB 卡的意义在于,它能把权重和缓存同时放进可控区间,长上下文才不会被压缩到不可用。
CPU 和内存也不能忽略。vLLM 的调度、分词和编译都依赖主机资源。经验上核数最好达到卡数的 8 到 16 倍,内存不低于权重总量的 2 倍。本次 2 卡配置用 32 核和 220GB 内存,运行期间主机内存占用约 11GB,余量充足。
2.2 系统盘写满,服务就起不来
推理服务启动时会写入多个位置:临时文件、编译缓存、JIT 编译产物。系统盘只有 40GB,任何一处写满,初始化就可能中止。
正确做法是把写入点统一迁到数据盘:
TMPDIR指向/data/tmpVLLM_CACHE_ROOT指向/data/vllm-cache
这里最容易踩的坑是目录属主不对。目录如果是 root 创建的,运行用户可能没有写权限,FlashInfer 的 JIT 编译就会失败。
2.3 参数乱设,性能上不去
max-model-len 不是越大越好,它直接决定 KV 缓存预算。--max-num-seqs 越高,批处理收益越大,但单条序列速度会被摊薄。--gpu-memory-utilization 设得过高会压缩缓存余量,设得过低又会浪费显存。
三、不同方案对比:24GB 双卡张量并行 vs 48GB 数据并行
| 方案 | 显存占用 | 单流延迟 | 总吞吐 | 工程复杂度 | 适合场景 |
|---|---|---|---|---|---|
| 24GB 双卡张量并行 | 权重分片,KV 缓存紧张 | 较高,跨卡通信有开销 | 中等 | 高 | 预算有限,能接受延迟 |
| 48GB 单卡数据并行 | 权重完整,缓存充足 | 低 | 高 | 低 | 个人或小团队 |
| 48GB 双卡数据并行 | 每卡完整实例 | 低 | 近似翻倍 | 低 | 小团队共享、自动化流水线 |
| 更低比特 GGUF | 显存最低 | 取决于量化 | 中等 | 中 | 牺牲 vLLM 工具调用生态 |
27B FP8 权重加载后实测占用 27.6GiB,当前更适合数据并行而不是张量并行。数据并行的好处是每张卡独立承载完整实例,互不干扰,整体吞吐更高。如果单卡放不下权重和 KV 缓存,才需要张量并行。张量并行会引入跨卡通信,单流延迟通常高于数据并行。
四、为什么选择 UCloud 48GB GPU 云主机 + 数据并行
4.1 开通流程
以 UCloud 控制台为例,流程是云主机 UHost → GPU 型。
- 机型选择 RTX40 系高显存机型,优先挑 48GB 版本;
- 地域和可用区优先选择有现货的区域,并提前确认后续扩容时的库存;
- 镜像选择 Ubuntu 22.04 且预装 GPU 驱动的版本,可直接省去驱动安装;
- 磁盘至少准备 40GB 系统盘和 200GB 以上数据盘;
- 安全组默认只放行 SSH,推理端口在验证通过后再按源 IP 放行。
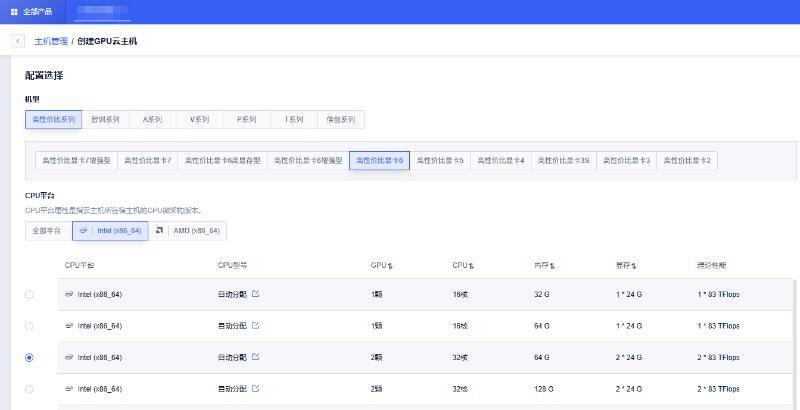
图 1: image-1.png
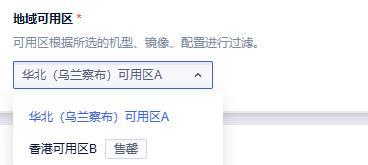
图 2: image-2.png
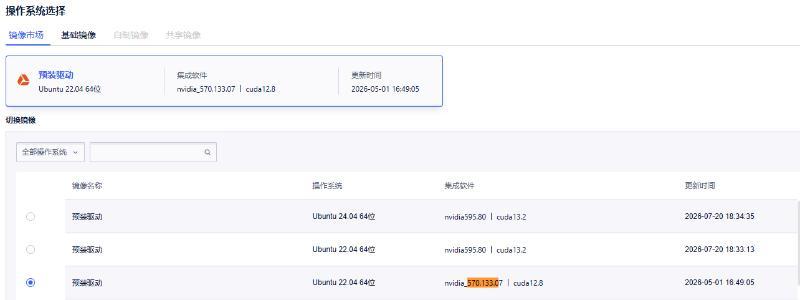
图 3: image-3.png
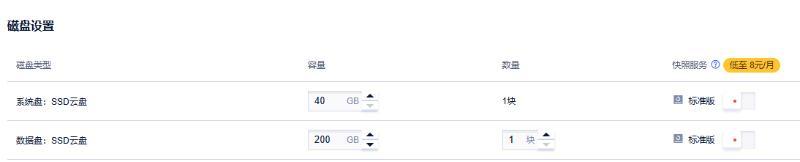
图 4: image-4.png
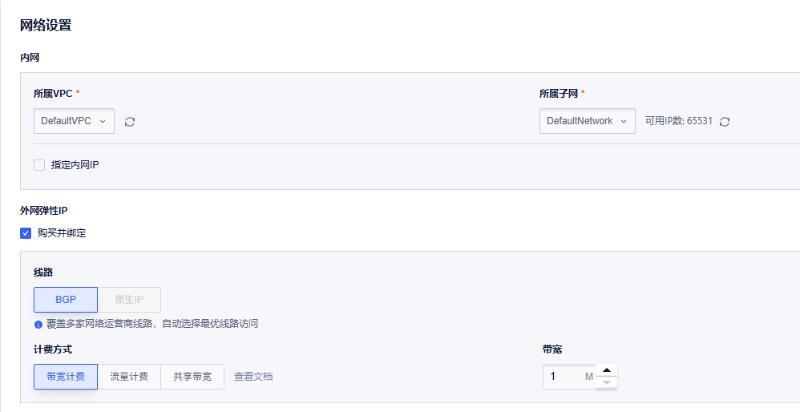
图 5: image-5.png
4.2 计费方式的取舍
- 先试后买:适合先跑通下载、部署和验证流程。
- 按量计费:适合夜间批处理、临时压测和短周期任务。
- 包月或包年:适合常驻推理服务,也是这套部署的实际选择。
双卡 48GB 常驻运行时,按量跑满一个月的成本通常明显高于包月,因此常驻场景没有必要长期按量。
4.3 系统初始化
先确认卡数、显存、驱动版本和 CUDA 工具链,再进入部署。
nvidia-sminvcc --versioncat /etc/os-release
本次镜像环境为两张 RTX 4090、驱动 570.133.07、CUDA 12.8、Ubuntu 22.04.4。若驱动或 CUDA 不完整,应优先按云厂商官方文档处理,不要直接套用第三方脚本。
数据盘已自动挂载到 /data 时,直接确认即可:
lsblk -f
如果没有自动挂载,就手动格式化并写入 fstab,避免重启后模型“消失”。
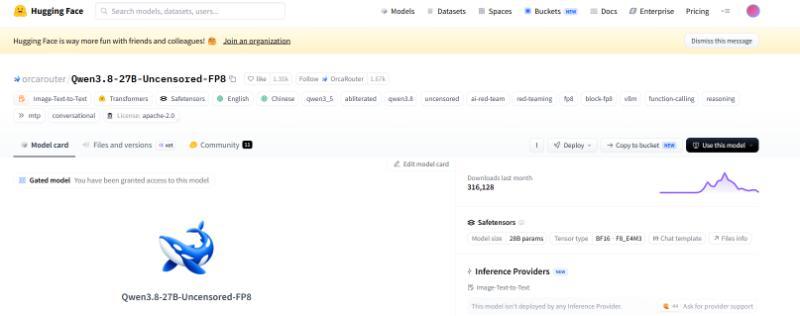
图 6: image-7.png
4.4 模型下载与校验
该仓库在 Hugging Face 上是 gated 状态,下载前要先完成页面授权,再在服务器上登录同一账号的 token。账号不一致时仍会被拒绝。
下载前建议关闭 Xet 协议解析,避免镜像环境里出现解析失败。数据量约 31GB,下载中偶发断连属于正常现象,hf 支持续传。
模型目录中的 model.safetensors.index.json 声明了权重总字节数。把声明值和本地分片大小求和比对,就能快速判断权重是否完整。本模型的期望值为 30866867136 字节。这个检查只需几秒钟,但能避免服务起不来时才发现权重损坏。
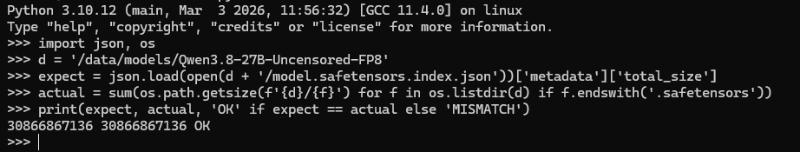
图 7: image-8.png
五、实际使用建议:启动配置与验证
5.1 推理环境
在数据盘单独创建虚拟环境,避免污染系统 Python。安装完成后,要先确认框架能识别模型架构文件,再进入启动阶段。
5.2 启动配置
当前有效配置的核心参数如下:
--max-model-len 131072
--max-num-seqs 8
--gpu-memory-utilization 0.9
5.3 验证
启动后先跑一次单流请求,确认延迟和吞吐达标,再开放给团队使用。
参数 当前值 作用 --data-parallel-size 2 每张卡跑一个完整实例,吞吐近似翻倍 --max-model-len 131072 提供 128K 上下文上限 --max-num-seqs 4 控制单实例并发
max-num-batched-tokens 16384 控制预填充批量大小 --gpu-memory-utilization 0.95 给权重和 KV 缓存分配主要显存预算 --speculative-config MTP 投机解码 这是提速最明显的优化 --enable-prefix-caching 开启 提升重复前缀的预填充效率 --host 127.0.0.1 只接受本机流量,外部通过代理访问
服务以 systemd 托管后,可实现自动拉起和失败重启。推理进程本身不直接暴露公网,只把本机端口交给前置代理转发,这样暴露面更小。
5.3 启动验证
首次启动通常需要 4 到 8 分钟,主要耗时在 Inductor 编译和 CUDA Graph 捕获。缓存写入数据盘后,后续启动会明显变快。
验证时先确认模型列表能正常返回,再做一次短对话请求:
- curl -s -H 'Authorization: Bearer <key>' http://127.0.0.1:11435/v1/models
- curl -s -H 'Authorization: Bearer <key>' -H 'Content-Type: application/json' -d '<JSON body>' http://127.0.0.1:11435/v1/chat/completions
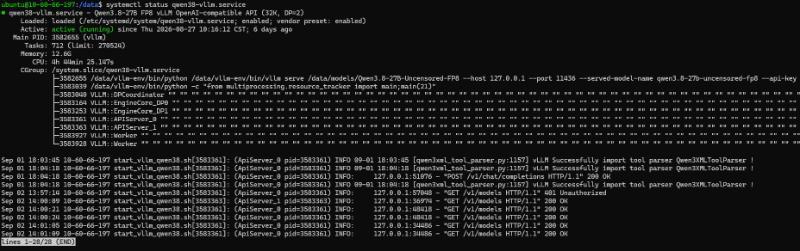
图 8: image-10.png
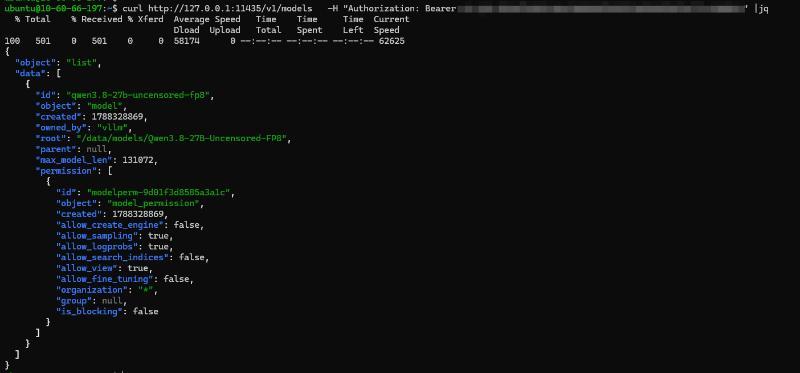
图 9: image-6.png
5.4 关键参数解读
并行方式:27B FP8 权重加载后实测占用 27.6GiB,当前更适合数据并行。数据并行每张卡独立承载完整实例,互不干扰,整体吞吐更高。
上下文长度:这个模型采用混合注意力结构,只有一部分层使用全注意力,因此每 token 的 KV 开销明显低于同规模纯注意力模型。实测可用预算约 14.2GiB,单卡总容量报告约 221,880 tokens。重点不是把上限设得越大越好,而是让上限和实际任务长度匹配。
吞吐相关参数:--max-num-seqs 越高,批处理收益越大,但单条序列速度会被摊薄。--max-num-batched-tokens 影响长输入的分块预填充粒度。--gpu-memory-utilization 设得过高会压缩缓存余量,设得过低又会浪费显存。
功能相关参数:--dtype auto 让引擎读取模型量化声明,FP8 模型不应手工改成别的精度。--language-model-only 可跳过视觉塔,节省约 1 到 2GB 显存。--reasoning-parser qwen3 和 --tool-call-parser qwen3_xml 用于解析思考内容和 XML 工具调用。--chat-template 建议显式指向仓库自带模板,避免模板解析不一致。
六、性能优化:MTP 投机解码是收益最高的那一步
6.1 基线
首次测速在单流、固定提示词条件下得到两组结果:
- 212 tokens,10.5 秒,20.1 tok/s
- 190 tokens,9.4 秒,20.1 tok/s
这个速度对 27B FP8 加 48GB 4090 来说偏慢,说明还有优化空间。
6.2 启用 MTP 投机解码
收益最大的优化是启用 MTP 投机解码。模型自带 MTP 头,vLLM 对这类结构有原生支持,只需要打开对应配置即可。
启动日志出现 Detected MTP model. Sharing target model lm_head weights with the draft model. 时,说明 MTP 已经生效。启用后,单流速度提升约 55%。
投机解码的机制是先由草稿头预测下一个 token,再由主模型验证。只要验证通过,输出分布就和逐字生成一致,因此这是无损加速。
6.3 其他已启用项
-O3 编译优化、CUDA Graph、异步调度和前缀缓存都已经开启。对于 agent 类负载,前缀缓存对系统提示词和工具定义的重复预填充有实际收益。
6.4 推理侧使用建议
- 交互式场景可以保留思考模式,批量任务和工具调用建议关闭思考模式,以免输出大量推理 token。
- 并发请求优于串行请求。双实例总解码能力约 60 tok/s,异步提交比逐个等待更高效。
七、适合 / 不适合场景
场景 典型负载 推荐配置 适合的云主机 个人使用 1 到 2 并发,单轮 8K 以内 --data-parallel-size 1,--max-model-len 32768,--max-num-seqs 4 单张 48GB 卡,8 到 16 核,64GB 内存,200GB 数据盘 小团队共享 5 到 10 人日常使用,峰值约 10 并发 --data-parallel-size 2,--max-model-len 65536,--max-num-seqs 8 2 × 48GB 卡,32 核,220GB 内存,200GB 数据盘 自动化流水线 批量分析、夜间任务、对单条延迟不敏感 --data-parallel-size 2,--max-model-len 16384,--max-num-seqs 16 与小团队共享同档即可,优先再加一台同规格机器做横向扩容 长上下文专项 代码审计、大文档分析、1 到 3 并发 --data-parallel-size 2,--max-model-len 131072,--max-num-seqs 2 与小团队共享同档即可,重点是显存而不是再加卡
超出双卡规模时的处理顺序:
- 先做水平加机,用负载均衡线性扩容;
- 再考虑把 KV 缓存改成更低精度,换取更长上下文;
- 最后才升级到更大的多卡或裸金属规格。
如果预算只够 24GB 卡,当前 FP8 权重单卡放不下,要么走双卡张量并行,要么切换到更低比特 GGUF 方案,但后者会牺牲 vLLM 的工具调用生态。
八、总结建议
这套部署的核心经验只有四条:
- 云上部署先算显存账,再定卡型;
- 所有磁盘写入点都要尽量放到数据盘;
- 混合注意力模型的 KV 开销不能套用纯注意力经验值;
- MTP 投机解码值得默认开启。
当前线上状态是双实例、128K 上下文、单流约 31 tok/s、总吞吐约 60 tok/s,能够稳定承载内部安全自动化和代码审计负载。
九、FAQ
9.1 为什么优先用数据并行?
因为单卡已经能放下权重和必要缓存时,数据并行的工程复杂度更低,总吞吐也更容易提升。
9.2 为什么把缓存和临时文件都迁到数据盘?
因为系统盘空间太小,模型加载、JIT 编译和缓存写入都可能把它写满,启动失败常常就出在这里。
9.3 128K 上下文会不会浪费显存?
不会。max-model-len 是上限,不是固定预留,KV 缓存按需分配。
9.4 思考模式太慢怎么办?
批量任务和工具调用可以关闭思考模式,只在深度推理任务里开启。