2026年大模型推理GPU怎么选?A100、H800、H20、4090四张卡的真实取舍
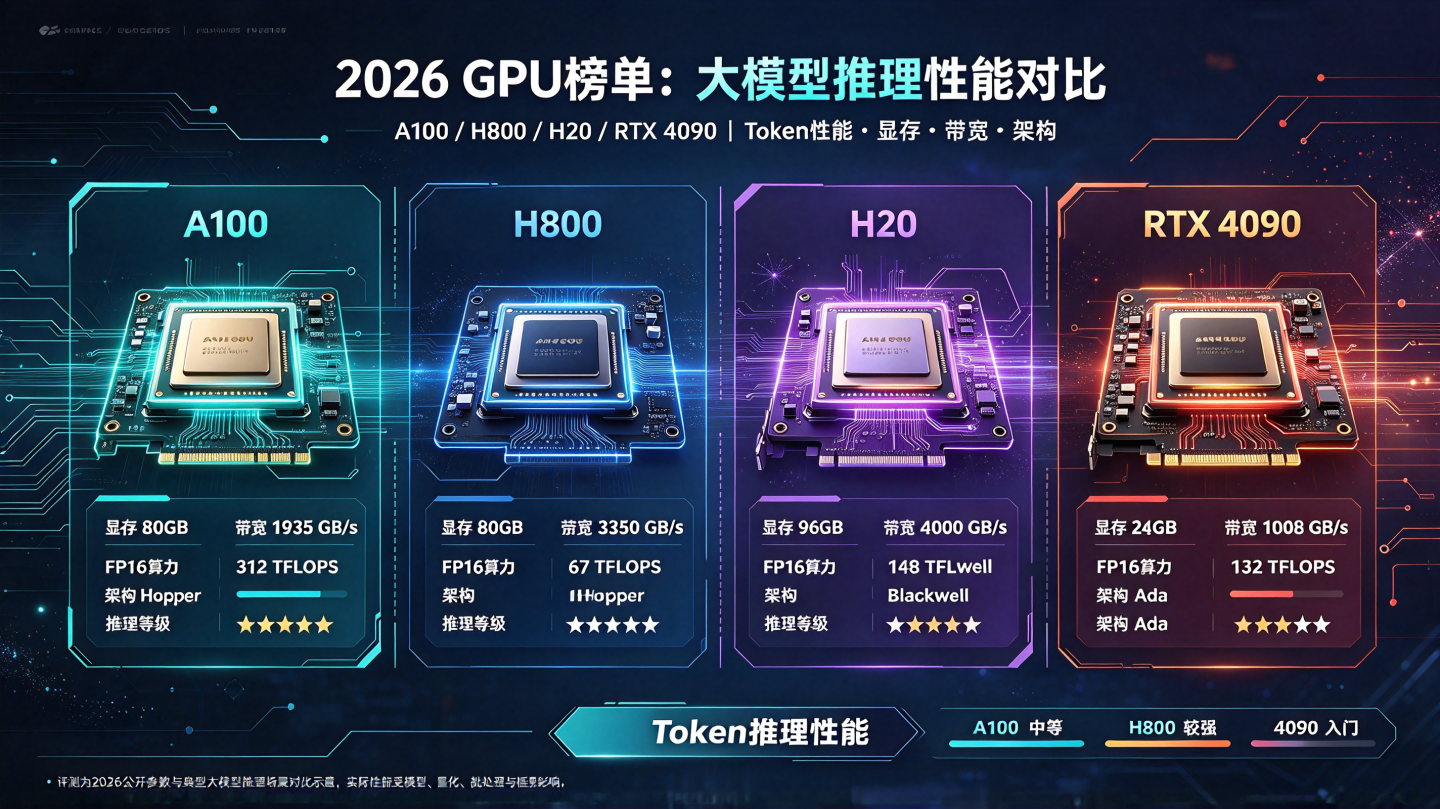
数据核验日期:2026 年 10 月。规格数据来自 NVIDIA 官方 datasheet 与架构白皮书,Token 推理性能参考 MLPerf 等公开 benchmark。
大模型推理选卡,最容易踩的坑是只看 TFLOPS。实际上 Prefill 阶段看算力,Decode 阶段看显存带宽,模型能不能装下看显存容量,多卡扩展看 NVLink 互联。这四个维度里任何一个短板,都会让整卡在实际业务中表现不及预期。
先把结论放在前面:
- NVIDIA H100 / H800:单卡推理性能最强,80 GB HBM3 + 约 3 TB/s 带宽,FP16 Tensor 989 TFLOPS。适合跑 70B 大模型、有推理吞吐硬指标的场景。
- NVIDIA H20:显存带宽 4 TB/s 是四张最高,96 GB 显存能装更大模型,但 FP16 Tensor 算力被砍到 H100 的 15%。适合长上下文推理、大 batch 生成、显存优先的场景。
- NVIDIA A100:Ampere 上一代旗舰,80 GB HBM2e + 1.5 TB/s 带宽,FP16 Tensor 312 TFLOPS。生态最成熟、二手货源多、性价比稳定,但比 H100 差一代。
- NVIDIA RTX 4090:消费级 Ada Lovelace,24 GB GDDR6X + 1 TB/s 带宽,FP8 Tensor 660 TFLOPS。单卡能装 13B 模型,性价比之王,但显存小、扩展弱。
综合定位:
| 位次 | 卡型 | 核心优势 |
|---|---|---|
| 综合最强 | H100 | 算力带宽显存互联四项全平衡,训练推理通吃 |
| 长上下文 / 大 batch 推理 | H20 | 4 TB/s 显存带宽 + 96 GB HBM3,Decode 阶段占优 |
| 性价比与生态成熟度 | A100 | 二手货源多、CUDA 生态最稳、单卡价格友好 |
| 消费级 / 单机开发 | RTX 4090 | 消费卡里最强,24 GB 显存能跑 13B,成本最低 |
不做综合第一硬排名,因为不同模型规模、上下文长度、batch size 下最优选择差异很大。
一、为什么现在要重新看这个问题
2025 到 2026 年,大模型推理选型有三个变化:
- 70B 级模型成为通用能力门槛。GPT-4 级、Claude 3.5 级、DeepSeek-V3 671B、Llama 3.1 70B 都在往更大规模走。选卡之前先想清楚要跑多大的模型,显存装不装得下是硬门槛。
- 推理成本压力反超训练。长上下文场景 KV Cache 占显存越来越重,带宽成为 Decode 阶段的主要瓶颈。选卡看「每张卡的 Token/s」比看「每张卡的 TFLOPS」更重要。
- 出口管制持续扰动供给。H100 系列因出口管制在国内受限,H20 是合规主推型号但算力被大幅削减,4090 因价格低廉成为国内 AI 团队的性价比选择,A100 二手货源充足但一代落后。
二、四张卡的核心矛盾
官方规格一览:
| 规格 | A100 80GB SXM | H100 SXM5 | H800 SXM5 | H20 96GB SXM | RTX 4090 |
|---|---|---|---|---|---|
| 架构 | Ampere (GA100) | Hopper (GH100) | Hopper (GH100) | Hopper (GH100) | Ada Lovelace (AD102) |
| 显存容量 | 80 GB HBM2e | 80 GB HBM3 | 80 GB HBM3 | 96 GB HBM3 | 24 GB GDDR6X |
| 显存带宽 | 1555 GB/s | 约 3 TB/s | 约 3 TB/s | 4 TB/s | 1008 GB/s |
| FP16 / BF16 Tensor | 312 TFLOPS | 989 TFLOPS | 989 TFLOPS | 148 TFLOPS | 330 TFLOPS |
| FP8 Tensor | 不支持 | 1979 TFLOPS | 1979 TFLOPS | 296 TFLOPS | 660 TFLOPS |
| NVLink | Gen 3(400 GB/s) | Gen 4(900 GB/s) | Gen 4(400 GB/s) | Gen 4(900 GB/s) | 无 |
| TDP | 300-400W | 700W | 700W | 350-400W | 450W |
| MIG 虚拟化 | 支持 | 支持 | 支持 | 支持(最多 7 实例) | 不支持 |
四条关键判断:
- 单卡最大显存:H20(96 GB)> A100 / H100 / H800(80 GB)> 4090(24 GB)
- 最高显存带宽:H20(4 TB/s)> H100 / H800(约 3 TB/s)> A100(1.5 TB/s)> 4090(1 TB/s)
- 最强 Tensor 算力:H100 / H800(989 TFLOPS FP16)> 4090(330 TFLOPS)> A100(312 TFLOPS)> H20(148 TFLOPS)
- 最强互联:H100 / H20(900 GB/s NVLink)> A100 / H800(400 GB/s)> 4090(无)
背后的取舍逻辑:
- 能装下模型是硬门槛:Llama 3 70B FP16 需约 140 GB 显存,单卡装不下,需 2 张 H100 / H800 或 2 张 H20。Llama 3 8B FP16 需约 16 GB,四张卡都能跑。
- Decode 阶段看带宽:显存带宽决定 KV Cache 的读取速度,直接影响 Token/s。H20 的 4 TB/s 是 H100 的 1.3 倍,长上下文场景有明显优势。
- Prefill 阶段看算力:H100 / H800 是 989 TFLOPS,H20 只有 148 TFLOPS,处理长 prompt 时 H20 会慢。
- 多卡扩展看 NVLink:70B 模型张量并行需要高速互联,NVLink 带宽不足会显著影响训练和推理效率。
三、四张卡逐张点评
3.1 H100 SXM5
Hopper 架构,台积电 4N 制程,首次引入 Transformer Engine 与原生 FP8。80 GB HBM3,带宽约 3 TB/s,FP16 Tensor 989 TFLOPS,FP8 Tensor 1979 TFLOPS。NVLink Gen 4,带宽 900 GB/s,是 A100 的 2.25 倍。支持 8 卡 HGX 全互联,DGX H100 单机可达 32 PFLOPS FP8。
MLPerf Training v3.0 显示 H100 系统跑 GPT-3 175B 比 A100 快约 2.8 倍。
适合:大规模模型训练、70B 以上推理、需要极致吞吐和延迟的企业级场景。
注意:单卡价格约 3 万美元,700W TDP 对机房散热压力大。国内因出口管制无法合法采购。
3.2 H800 SXM5
架构与算力与 H100 完全一致,同样是 Hopper GH100。关键差异两点:NVLink 带宽被砍到 400 GB/s(H100 是 900 GB/s),FP64 被砍到 1 TFLOPS。这两个限制是为合规出口管制做的调整。
单卡推理性能与 H100 基本一致,因为推理瓶颈主要在显存带宽和算力,与 NVLink 关系不大。多卡训练场景下 NVLink 砍半会影响大规模张量并行的通信效率。
DeepSeek-V3 就是用了 2048 张 H800、278 万 GPU-hours 训完的。
适合:单卡或少量卡推理、中小模型训练、DeepSeek-V3 这类国产大模型场景。
注意:2023 年 10 月出口管制升级后,H800 已不再合规,新采购需走历史渠道。
3.3 H20 96GB
Hopper 架构,96 GB HBM3 显存是四张卡最大,带宽 4 TB/s 也是四张最高。这是 H20 的核心卖点。
FP16 Tensor 只有 148 TFLOPS,FP8 Tensor 296 TFLOPS,仅为 H100 的 15% 左右。这是为合规出口管制做的算力削减。
NVLink 与 H100 一致的 900 GB/s,未被砍。
因带宽高达 4 TB/s,长上下文推理、大 batch 生成场景下,Decode 阶段性能可以追平甚至略超 H100。有分析称某些长上下文工作负载下 H20 比 H100 快约 20%。但 Prefill 阶段明显落后 H100。
适合:长上下文推理、大 batch 生成、显存压力大的场景。7B 到 70B 级大模型规模化推理、垂类微调、多租户 AI 平台是当前国内合规市场的主流应用场景。
注意:算力被砍导致不适合大规模训练。2025 年 4 月美国一度收紧 H20 出口,7 月又放开,采购前需关注政策变动。
3.4 RTX 4090
Ada Lovelace 架构,24 GB GDDR6X,带宽 1008 GB/s。显存容量和带宽都是四张卡最小。
FP16 Tensor 330 TFLOPS,FP8 Tensor 660 TFLOPS。算力水平介于 A100 与 H100 之间。
不支持 NVLink,只能走 PCIe Gen 4 x16。多卡扩展能力弱。
单卡能装下 Llama 3 8B FP16、Qwen 2.5 14B INT4、13B 级模型。70B 级模型需要 INT3 量化且显存非常紧张。
适合:个人开发者、AI 应用开发者、13B 及以下模型本地推理、图像生成、AI 辅助开发工具。
注意:无 NVLink 不支持多卡扩展;24 GB 显存跑 70B 级模型非常紧张;消费级卡的稳定性和散热不适合 7×24 服务器部署。
四、按场景怎么选
4.1 按模型规模选
| 模型规模 | 推荐 | 理由 |
|---|---|---|
| 7B 以下(Llama 3 8B、Qwen 2.5 7B) | 4090、A100、H100 / H800 / H20 均可 | 24 GB 显存已足够,看成本 |
| 13-14B(Qwen 2.5 14B、Llama 3 13B) | 4090(INT4)、A100 / H100 / H800 / H20 | 单卡能跑,INT4 量化后可选 4090 |
| 70B(Llama 3 70B、Qwen 2.5 72B) | H100 / H800(2 张 FP16)、H20(2 张 FP16)、A100(2 张) | 单卡装不下,必须多卡 |
| 100B 以上 | H100 多卡集群 | 需要大规模 NVLink 互联和算力 |
4.2 按场景选
| 场景 | 推荐 | 理由 |
|---|---|---|
| 大规模训练(70B+) | H100 | 算力带宽互联三项全能,训练吞吐最优 |
| 中等规模训练(13-70B) | H800、H100 | H800 单卡训练性能接近 H100 |
| 长上下文推理 | H20、H100 / H800 | H20 带宽 4 TB/s 在 Decode 阶段占优 |
| 大 batch 推理 | H20、H100 | 显存容量和带宽决定并发上限 |
| 低延迟推理 | H100 / H800 | 算力带宽均衡,Prefill Decode 都稳 |
| 中小模型本地开发 | 4090 | 单卡能跑 13B 级,成本低 |
| 图像生成(SD、FLUX) | 4090、H100 | 4090 消费级最强,H100 吞吐最高 |
| 多租户 AI 平台 | H20、H100 | 支持 MIG 虚拟化,H20 显存更大 |
4.3 按预算和合规选
| 预算 / 合规 | 推荐 | 理由 |
|---|---|---|
| 国内合规市场新增部署 | H20 | 目前国内可合法采购的最高性能推理卡 |
| 历史存量 / 存量维护 | A100 | 二手货源充足,性价比稳定 |
| 海外合规 | H100 | 训练推理本能旗舰 |
| 个人 / 团队入门 | 4090 | 消费级最强,成本最低 |
| 极致性能追求 | H100 集群 | 不差钱选这个 |
五、国内云厂商怎么选
同一张卡在国内哪家云上买,价格能差 3 倍、可用性差几个数量级。国内云主战场是 H20 和 4090,H100 属于灰色地带。
云厂商能力一览:
| 云厂商 | 主打卡型 | 独家方案 | 一句话总结 |
|---|---|---|---|
| 阿里云 | H20 96G / 4090 | H20 141G(独家) | 实例族最全,H20 主售 |
| 腾讯云 | H800 / 4090 | H800 集群(独家) | 白名单开放,H800 集群 3.2 Tbps RDMA |
| 华为云 | 昇腾 910B / A100 | 昇腾信创合规 | 政企军工唯一合规路径 |
| 百度智能云 | A100 / 昆仑芯 | 昆仑芯 P800 | PaddlePaddle 生态最深 |
| UCloud | 4090 / H20 | 4090 9.9 元试用 | 消费级卡性价比之王 |
| AutoDL 等 | 4090 / A100 | 社区最普及 | 关机不收费,试用友好 |
5.1 阿里云:H20 主售 + 独家 141G 版
主力卡型:
- H20 96G:主售,1-8 卡可选,192 核 1024G 整机,国内 H20 现货最充足
- H20 141G(独家档位):141 GB 单卡显存,能装下 70B FP16 全量权重,长上下文推理的天花板
- A100 80G:47.4 元/卡时,训练通用方案
- 4090 / 4090D 48G:19-25 元/卡时,推理入门
- L20 48G:30-70B 模型推理专用,20.18 元/卡时
独家优势:
- H20 141G 是国产云独家档位,141 GB 显存单卡装 70B 模型
- H20 机密计算版满足金融医疗合规
- PAI 平台大模型训练推理一体化
适合:国内合规大模型推理生产、70B 全量 FP16 部署、多租户 AI 平台。
5.2 腾讯云:H800 集群独家
主力卡型:
- H800 80G:白名单申请,8 卡集群 + 3.2 Tbps RDMA 全互联,国内唯一
- A100 80G:GT4 实例主售,A800 集群可开
- 4090:单卡约 2.2 元/时,8 卡整机包月约 9600 元,主流云里最低
独家优势:
- H800 集群是国内主流公有云唯一方案,8×H800 + 3.2 Tbps RDMA 组网
- 微信生态 + CDN 深度整合,出海业务友好
- 地域覆盖最广,中国香港、新加坡、法兰克福、硅谷等地域都可用
适合:70B 模型训练、多卡并行、微信生态业务。
5.3 华为云:昇腾 + NVIDIA 双线
主力卡型:
- A100 80G G1 型:8 卡 SXM 整机包月约 3.5 万元,NVSwitch + RoCEv2
- 昇腾 910B / 910C:Atlas 800 集群,8 卡整机约 2.2 万元/月
- H100 / H20:有售但配额稀缺,不主推
独家优势:
- 昇腾 910B 是政企、军工、金融国产化替代的唯一合规方案
- 昇腾 + ModelArts + MindSpore 三件套,国内除百度外最完整的国产 AI 栈
- 等保三级 + 政务云资质齐全
适合:政务 AI 平台、信创合规、军工项目、金融行业国产化。
5.4 百度智能云:国产昆仑芯主力
主力卡型:
- A100 80G:主售,PaddlePaddle 深度适配,4-7 万元/月(8 卡)
- 昆仑芯 P800:国产替代,32 GB GDDR6,30000 片训练集群已部署
- H100 / H800 / H20:有售但配额长期不稳定
独家优势:
- PaddlePaddle + ERNIE 生态,DeepSeek / Qwen 有官方优化版
- 昆仑芯 P800 是唯一规模化商用的国产 AI 芯片方案
- Q1 2026 GPU 云收入同比增长 184%
适合:PaddlePaddle 用户、DeepSeek / Qwen 微调、国产替代探索。
5.5 UCloud 优刻得:消费级卡性价比之王
主力卡型:
- RTX 4090 24G:活动月租 1212 元,9.9 元/天试用,全国最低门槛
- 4090D 48G:1999 元/月,国产云唯一公开的 4090 高显存版
- H20 96G:7.5 元/时按需 + 关机不收费,4500 元/月包月
- A100 80G / A800 80G:优云智算按需,A800 6.23 元/时是国内公开市场最低
独家优势:
- 4090 日卡 9.9 元试用,入门成本最低
- 4090D 48G 独家,1999 元/月能装 24B 模型
- A800 80G 6.23 元/时,国内大显存卡最便宜
- 海外 32 节点支持出海业务,中文客服
适合:消费级 4090 入门、短期验证、出海业务、个人开发者。
5.6 AutoDL / 星宇智算 / 极云托管:GPU 算力市场
国产 GPU 算力市场比主流云便宜 30-50%,但稳定性和 SLA 相对弱。
- AutoDL:AI 团队最常用,4090 1.5 元/时起、A100 3.3 元起,社区氛围好
- 星宇智算:8 卡整机性价比最高,4090 8 卡 8800 元/月、4 机 32 卡包季 26.4 万元
- 极云托管:H20 8 卡整机 29200 元/月、4090 8 卡 7920 元/月
适合:GPU 试用、快速验证、中小团队短期训练、性价比优先场景。
5.7 按业务场景匹配
| 业务场景 | 首选卡型 | 首选云厂商 | 备选方案 |
|---|---|---|---|
| 国内大模型推理生产 | H20 96G | 阿里云 | UCloud、腾讯邀测 |
| 70B 全量 FP16 部署 | H20 141G | 阿里云(独家) | — |
| 长上下文 128K+ 推理 | H20 96G | 阿里云 | UCloud |
| 多租户 AI 平台 | H20 96G MIG | 阿里云 | 优云智算 |
| 70B 模型训练 | H800 集群 | 腾讯云(独家) | H20 8 卡集群 |
| 政企信创 | 昇腾 910B | 华为云 | 昆仑芯 P800 |
| DeepSeek / Qwen 微调 | A100 80G | 阿里云 | 腾讯云、百度 |
| PaddlePaddle 生态 | A100 80G | 百度智能云 | 千帆平台 |
| 消费级 4090 入门 | RTX 4090 | UCloud(9.9 元试用) | AutoDL、腾讯云 |
| 48G 高显存推理 | 4090D 48G | UCloud(独家) | 阿里云、AutoDL |
| GPU 试用 / 快速验证 | 任意卡 | AutoDL、UCloud 优云智算 | — |
| 32 卡及以上集群 | 4090 / A100 / H100 | 星宇智算 | 华为云 Atlas |
| 出海业务(中国香港 / 东南亚) | H20 / A100 | UCloud 国际站 | 阿里云国际站 |
一句话总结:国内大模型推理主战场是阿里云 H20 + UCloud 4090,训练主战场是腾讯云 H800 集群 + 华为云 Atlas 昇腾,国产化替代是华为昇腾 + 百度昆仑。
六、FAQ
Q1:H20 显存带宽比 H100 高,是不是 H20 全面领先?
不是。H20 显存带宽 4 TB/s 确实比 H100 的 3 TB/s 高,但 H20 的 Tensor 算力只有 H100 的 15%。H20 是显存带宽和显存容量优先的卡,适合长上下文推理和大 batch 生成;训练和 Prefill 阶段场景 H100 更强。
Q2:H800 和 H100 到底差在哪里?
单卡推理几乎无差别,因为算力和显存带宽一样。主要差异两点:一是 NVLink 从 900 GB/s 砍到 400 GB/s,多卡训练和大规模张量并行会受影响;二是 FP64 从 67 TFLOPS 砍到 1 TFLOPS,不影响 AI 但影响科学计算。
Q3:4090 能跑 70B 大模型吗?
单卡勉强。Llama 3 70B FP16 需约 140 GB 显存,4090 只有 24 GB。用 INT4 量化后模型权重约 35 GB,加上 KV Cache 依然紧张。实践上建议用双 4090 或其他组合方案。
Q4:A100 现在是不是被淘汰了?
不算淘汰。A100 是 Ampere 上一代旗舰,FP16 Tensor 312 TFLOPS 只有 H100 的 30% 左右,缺少 Transformer Engine 和原生 FP8。但对 70B 以下模型、中小规模推理场景依然够用,生态成熟度是所有卡里最高的。
Q5:多张 H20 能弥补算力不足吗?
可以部分弥补。H20 NVLink 带宽保留 900 GB/s,多卡扩展效率不错。但对计算密集型的 Prefill 阶段,堆卡也难追上 H100 单卡的算力。
Q6:H20 为什么算力被砍这么狠?
为了合规 2023 年 10 月美国出口管制的升级要求。美国新规将算门槛从 A100 级减半,NVIDIA 只能推出大幅削减算力的 H20 来保持合规。作为补偿,H20 保留了 H100 级的显存带宽和 NVLink 带宽。
Q7:4090 是不是只能跑小模型?
不是。4090 单卡能跑 13B 级模型,双卡可以跑 70B 级 INT4 量化模型。但相比数据中心卡,稳定性、多卡扩展、生态支持都受限。
Q8:H20 会不会也被禁运?
有可能。2025 年 4 月美国曾一度收紧 H20 出口,7 月又放开。采购前需关注最新出口管制动态。
Q9:性价比怎么选?
个人开发者和 AI 应用开发选 4090(UCloud 1212 元/月、AutoDL 1.5 元/时起)。企业级推理选 H20 或 A100。大规模训练选 H100 或历史存量的 H800。
Q10:国内云为什么买不到 H100?
H100 因 2023 年 10 月出口管制被禁运,国内任何公开的 H100 供应渠道都是灰色货。云厂商公开售卖的 H100 集群基本都是历史存量或海外资源池转发。企业采购前请务必核实供应来源和合规状态。
Q11:UCloud 的 4090 为什么这么便宜?
消费级卡的官方驱动许可不允许云厂商大规模商用,但 UCloud 走的是面向个人开发者和短周期任务的定位(9.9 元/天试用、月租 1212 元),避开了企业级 7×24 SLA 的承诺成本。长期 7×24 生产环境还是建议选 H20 或 A100。
Q12:GPU 算力市场(AutoDL 这类)靠谱吗?
看具体平台。头部平台(AutoDL、星宇智算、极云)SLA 和运维质量已经接近主流云,价格却低 30-50%。小众平台稳定性存疑,重要生产任务建议走主流云。
七、结论总结
四张卡没有全能冠军,只有场景最优解。选型路径是:先确认模型能否装下(显存容量硬门槛),再判断瓶颈在 Prefill 还是 Decode(算力 vs 带宽),最后结合合规状态和预算做决策。H100/H800 是算力天花板,H20 是长上下文推理的带宽王者,A100 是生态与性价比的稳定选择,RTX 4090 是消费级入门的最优解。