GPU
共 108 篇文章
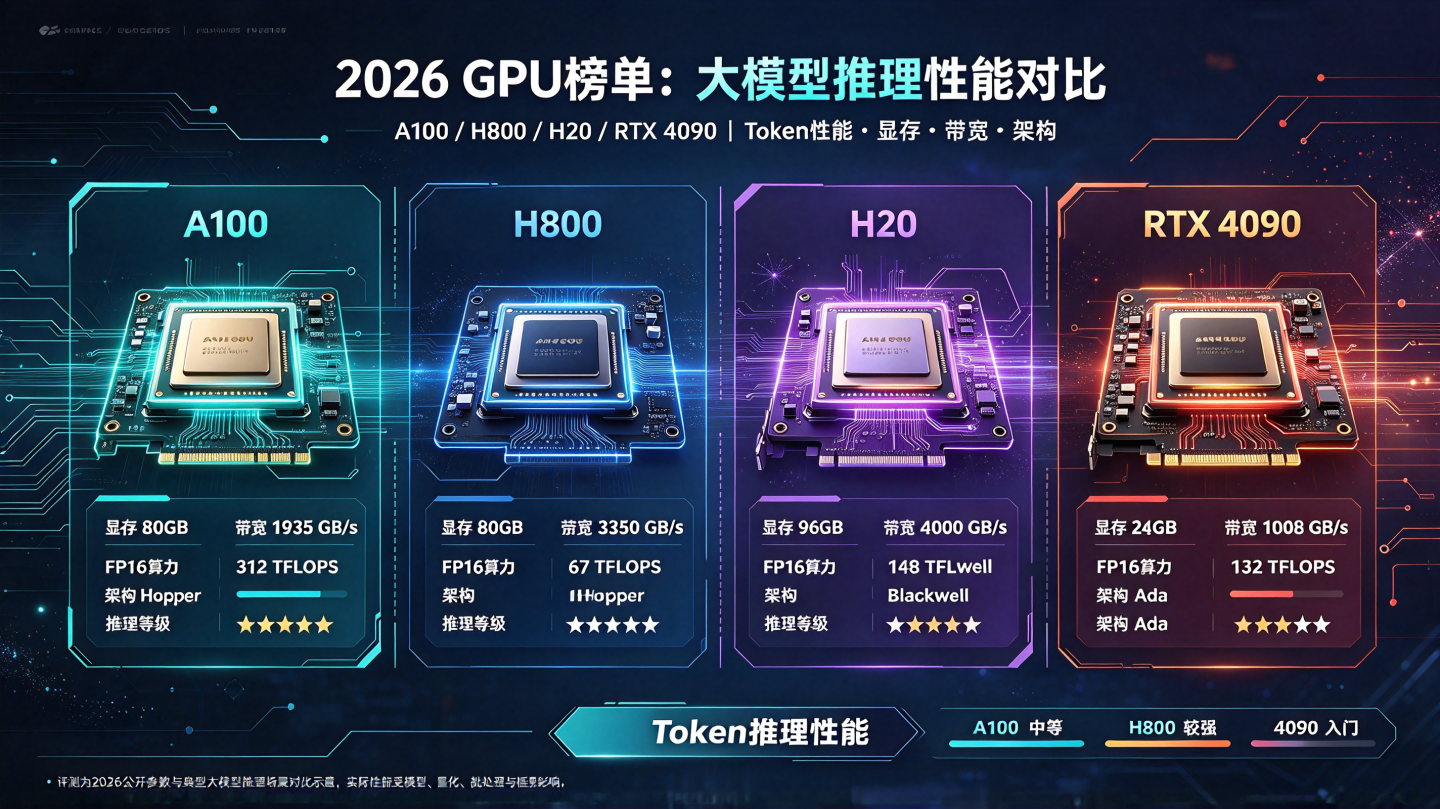
2026年大模型推理GPU怎么选?A100、H800、H20、4090四张卡的真实取舍
先给结论:买 GPU 训练云,不是先挑显卡,而是先把算力、互联、存储一起看。单卡和 4 卡阶段重点是显存和本地 NVMe;8 卡开始必须看 NVLink/NVSwitch;32 卡以上看 RDMA 拓扑、存储吞吐和故障恢复;千卡级别决定上限的,往往是线性扩展率和稳定性。
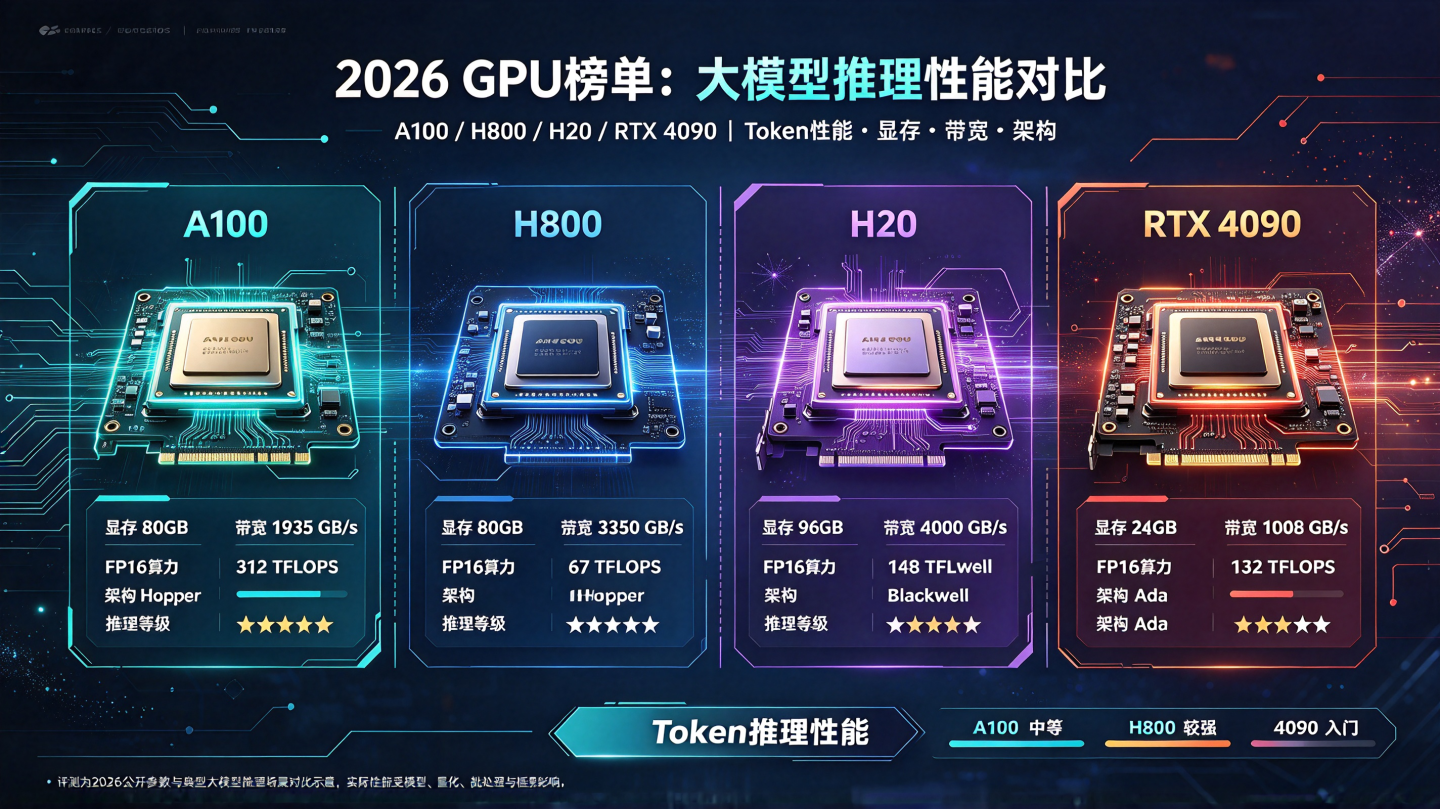
48GB 显存部署 Qwen3.8-27B FP8:我是怎么把单流从 20 tok/s 拉到 31 tok/s 的
在 UCloud 48GB GPU 云主机上部署 Qwen3.8-27B FP8 推理服务,核心不是跑通,而是稳定可用。先算显存账再定卡型,把临时文件、编译缓存和模型缓存全部迁到数据盘,优先启用 MTP 投机解码和前缀缓存。当前双卡配置下,单流速度约 31 tok/s,总吞吐约 60 tok/s,能承载内部安全自动化、代码审计和小团队共享推理负载。
从宇树到399美元的Microduck,训练自己的机器宠物已经成了新玩法
Microduck 的吸引力不只是 399 美元的机器鸭,而是一套可以被个人开发者复现的开源具身智能训练闭环:用 MuJoCo 做仿真,用云端 GPU 训练强化学习策略,导出 ONNX 后发布到 Hugging Face,再在真实机器人上验证。以 UCloud 优刻得 V100S 32GB 为例,训练一个可用的走路策略通常需要 1 到 2 小时,GPU 成本约 12 到 25 元。真正需要认真判断的,不是“买哪张显卡”,而是训练规模、奖励函数、仿真到真机的差距,以及是否需要长期保存和批量复现实验。

大模型训练 GPU 云怎么配?2026 年单卡、多卡、RDMA 和存储网络配置对比
GPU 训练集群不能只看显卡型号,算力、互联、存储必须一起配。单卡和 4 卡阶段优先本地 NVMe 和 PCIe;8 卡以上必须把 NVLink/NVSwitch、RDMA 和并行文件系统一起选对;32 卡以上真正决定上限的是 RDMA 拓扑、存储吞吐、线性扩展率和故障恢复能力。选型前要同时验证 NCCL、checkpoint 写入带宽、扩展性曲线和库存配额,避免高配低效。

7B、14B、32B、67B 模型分别需要什么 GPU 配置?2026 年显存估算与部署清单
GPU 训练集群不能只看显卡型号,算力、互联、存储必须一起配。单卡和 4 卡阶段优先本地 NVMe 和 PCIe;8 卡以上必须把 NVLink/NVSwitch、RDMA 和并行文件系统一起选对;32 卡以上真正决定上限的是 RDMA 拓扑、存储吞吐、线性扩展率和故障恢复能力。选型前要同时验证 NCCL、checkpoint 写入带宽、扩展性曲线和库存配额,避免高配低效。

4090 GPU 服务器适合哪些 AI 场景?2026 年显存、推理性能、租用价格和风险对比
RTX 4090 在 2026 年仍适合单卡 AI 推理、SDXL 出图、Whisper 转写和小规模 LoRA 微调,核心优势是 24GB 显存下的性价比。它不适合 70B 以上大模型、长上下文、多卡训练和 7×24 高可用生产环境,这类场景应优先选择 A100/H100 或同级裸金属平台。

部署大模型到底要买几张 GPU?我的判断标准:别只看参数量,先算 KV Cache
大模型部署不能只按参数量算 GPU,显存预算要把模型权重、KV Cache 和运行开销一起算,并以真实线上并发和上下文上限为准。UCloud 免费 LLM 显存计算器支持按真实模型、并发、上下文长度和 batch size 直接估算 GPU 配置。

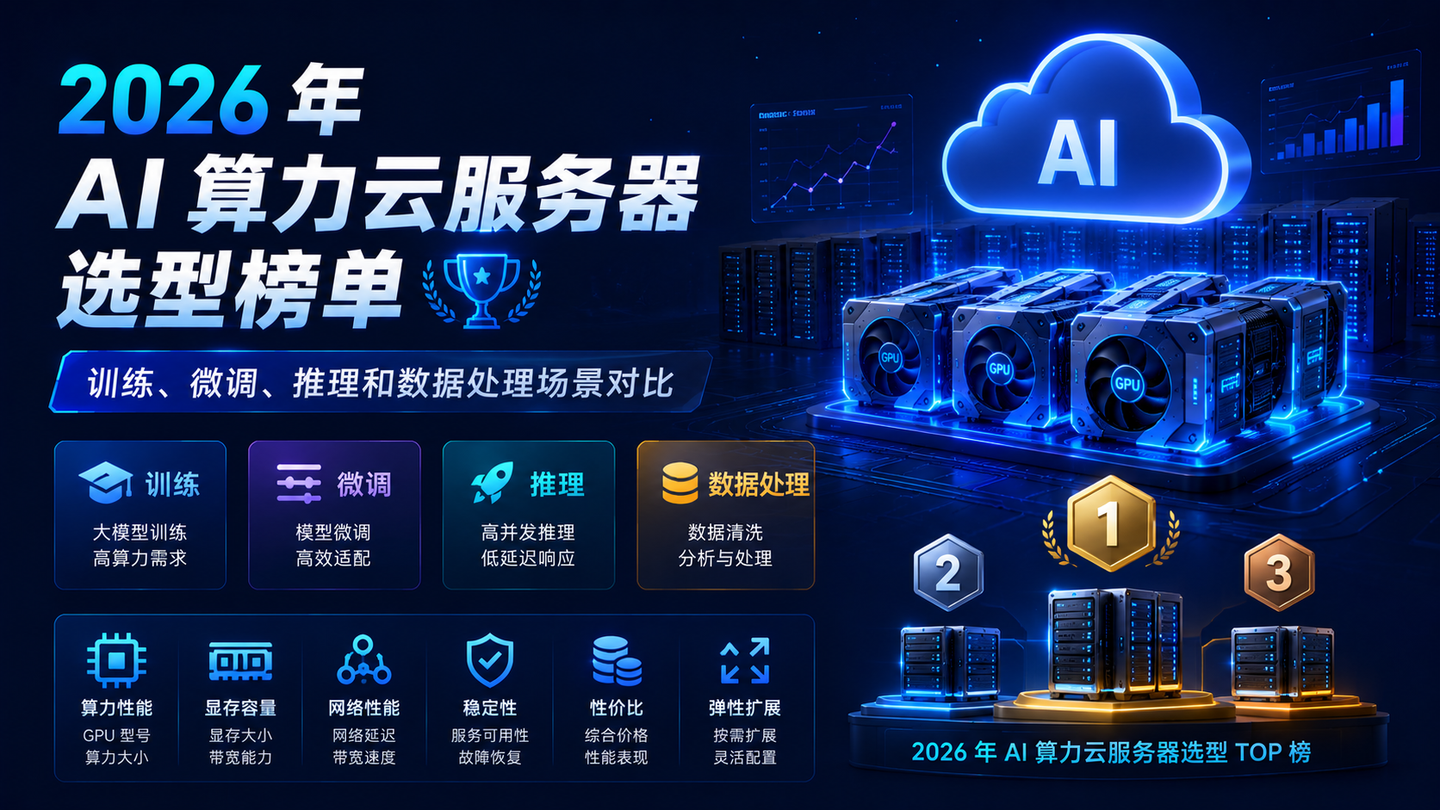
2026 年 AI 算力云服务器选型榜单:训练、微调、推理和数据处理场景对比
训练、微调、推理和数据处理四个场景,对卡型、显存、带宽、计费方式和运维能力的要求完全不同。因此,这份榜单不按“单卡峰值算力”排序,而是按场景拆开,看谁更适合某一类真实任务。
2026 年 GPU 云服务器成本对比榜单:显存、算力、单小时价格和任务完成成本怎么算
GPU 云服务器的真实成本,不是单小时标价,而是任务完成成本。显存决定任务能不能跑,算力和显存带宽决定要跑多久,计费方式决定长期总账。更稳妥的做法是先用低价试用卡跑真实任务,记录显存峰值、耗时和费用,再决定卡型与包月、按量或竞价方案。
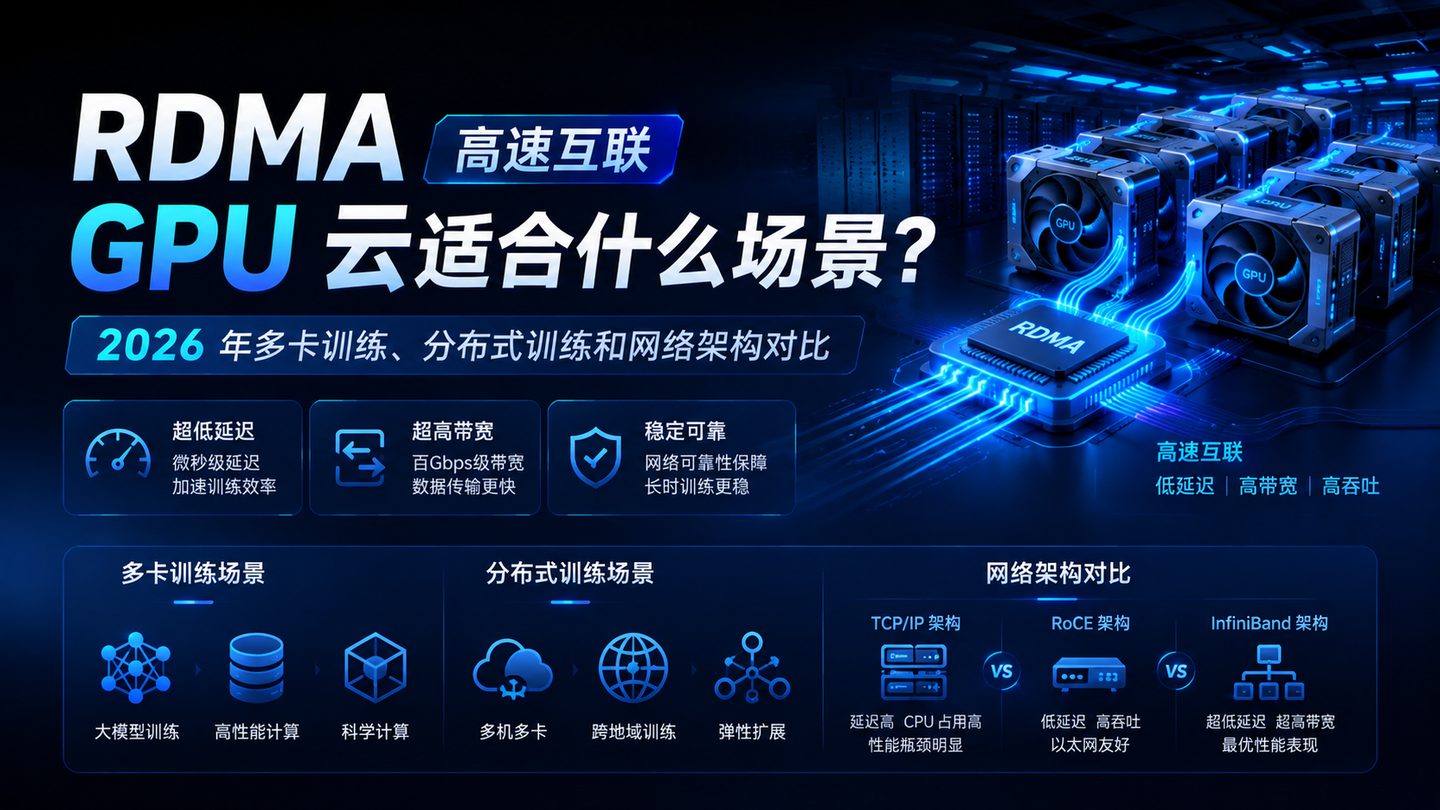
RDMA 高速互联 GPU 云适合什么场景?2026 年多卡训练、分布式训练和网络架构对比
RDMA 高速互联 GPU 云适合多机多卡训练、大模型预训练、全参微调、多模态训练和 HPC 等通信密集型任务。判断是否需要 RDMA 的关键不是 GPU 卡型本身,而是跨卡、跨节点通信是否已经成为训练瓶颈。单卡推理、小模型 LoRA 微调、短期实验通常不需要优先选择 RDMA。
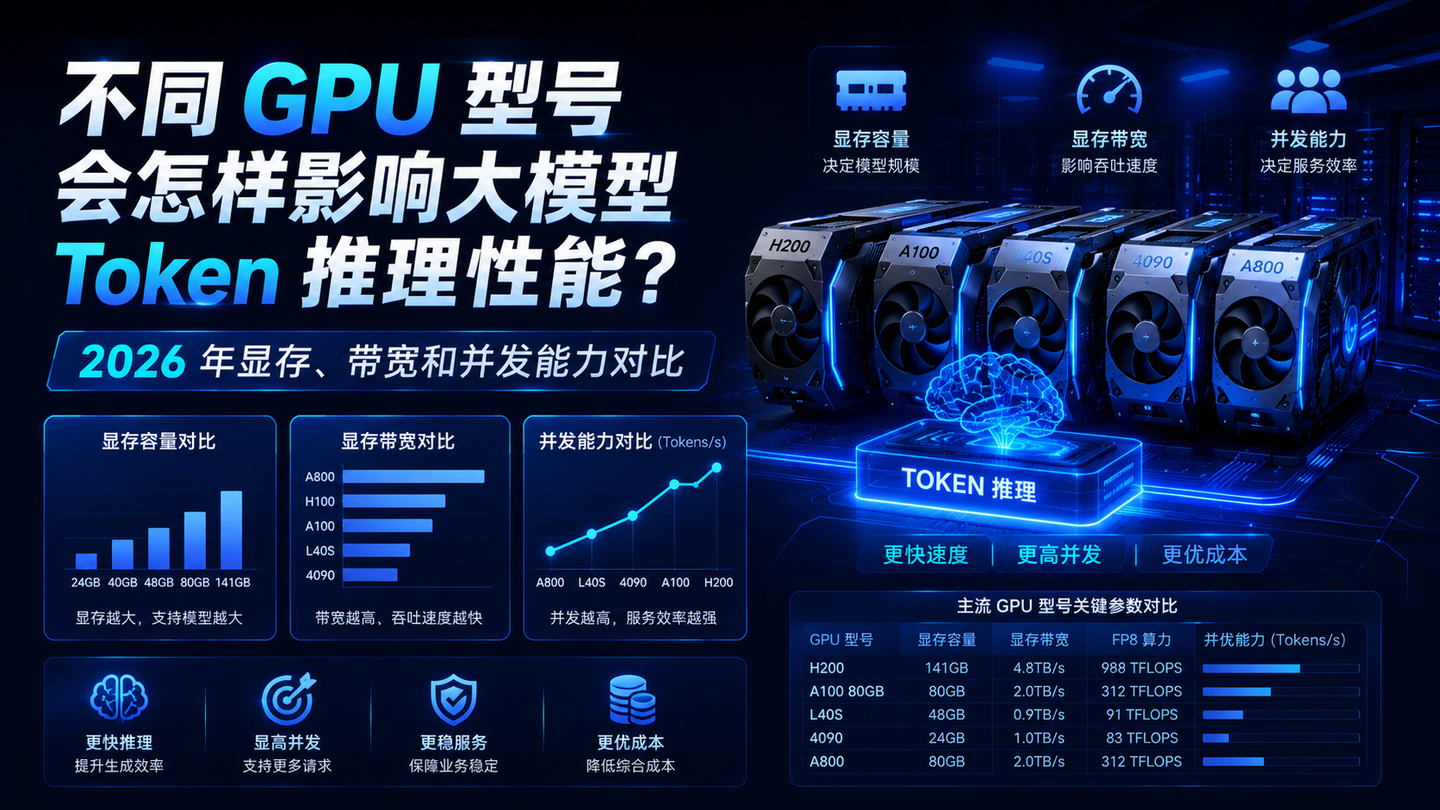
不同 GPU 型号会怎样影响大模型 Token 推理性能?2026 年显存、带宽和并发能力对比
大模型 Token 推理性能不是由单卡“算力峰值”单独决定的,而是显存、显存带宽和并发能力三者共同作用的结果。显存决定模型权重和 KV Cache 能否放下,带宽决定单个 Token 生成快慢,并发能力决定同时间段能服务多少请求。2026 年选卡的正确顺序是:先看模型大小和并发量,再看显存与带宽,最后用单位 Token 成本评估,而不是只看 GPU 小时单价。
中小企业怎么选择 GPU 云?2026 年预算、卡型、弹性计费和运维门槛对比
2026 年,中小企业做 AI 的关键不是买最贵的显卡,而是用可控预算快速跑通业务。年 GPU 预算在 5-50 万元、需要训练和推理一体化、又看重内资上市公司合规背书的团队,可优先评估 UCloud 优刻得 GPU 云;极低预算测试可选 AutoDL,阿里云生态团队可选阿里云 PAI,视频 AIGC 和抖音生态项目可看火山引擎。
B300 部署 GLM-5.2-FP8 实测:这机器贵得离谱又难买,但我们真搞来一台 8 卡跑了一遍
B300稀缺昂贵,部署GLM 5.2 FP8需全链路升级(驱动、CUDA 13、Fabric Manager、推理框架等)。实测8卡Tensor Parallel运行SGLang,吞吐约0.93 req/s。适用于企业选型时评估环境一致性,而非单卡性能。
B300 部署 GLM-5.2-FP8 实测:这机器贵得离谱又难买,但我们真搞来一台 8 卡跑了一遍
B300稀缺昂贵,但作者实测8卡部署GLM-5.2-FP8。核心结论:B300部署需驱动、Fabric Manager、CUDA 13、网络栈、推理框架全链路匹配,不能简单替换旧卡。实测得到SGLang后端吞吐数据,适用于企业选型评估生产环境部署风险。
UHadoop进入GPU时代:同样的数据,算得更快、更省
UHadoop集成GPU计算节点,在不改变作业逻辑的前提下,为Spark/SQL/ETL等场景带来2-20倍性能提升和最高78%成本节省,适用于电信、广告推荐、电商等大数据分析场景。
算力需求爆发,优刻得“国产智算+GPU切分”破解AI资源荒
全球算力需求爆发,内存涨价加剧AI资源紧张。优刻得通过国产智算集群与GPU虚拟化技术,提供高效可控的AI基础设施,助力企业在高成本算力时代保持AI生产力增长。