AI油画视频怎么做才不废片?我踩了五六条坑后用AstraStudio总结的提示词写法
最近AI油画在短视频平台热度很高,不少经典油画被做成动态视频,还配上了剧情。
连着刷了十几条这类视频后,自己也动手做了几个。但前几条基本是废片。
第一次直接把"让戴珍珠耳环的少女动起来"丢给AI,结果她的脸歪了,珍珠耳环变成塑料球,画面像被磨皮滤镜糊过一遍,油画笔触全没了,跟真人扮演似的。
第二次上传了参考图,人是动了,但动得很奇怪。身体在转,头巾纹丝不动,像戴了个面具。背景里凭空多出一盏烛台和一张桌子,原画里根本没有。
第三次运镜写成了"缓缓推近",AI直接给了个第一人称奔跑视角,画面抖得像手持DV,完全不是油画该有的静谧感。
前前后后废了五六条,花了小二十块,才摸出点门道。
下面这条是《撑阳伞的女人》拓展出来的,原画是一个女人撑着阳伞站着,现在还能多一段女人抱住孩子的画面。
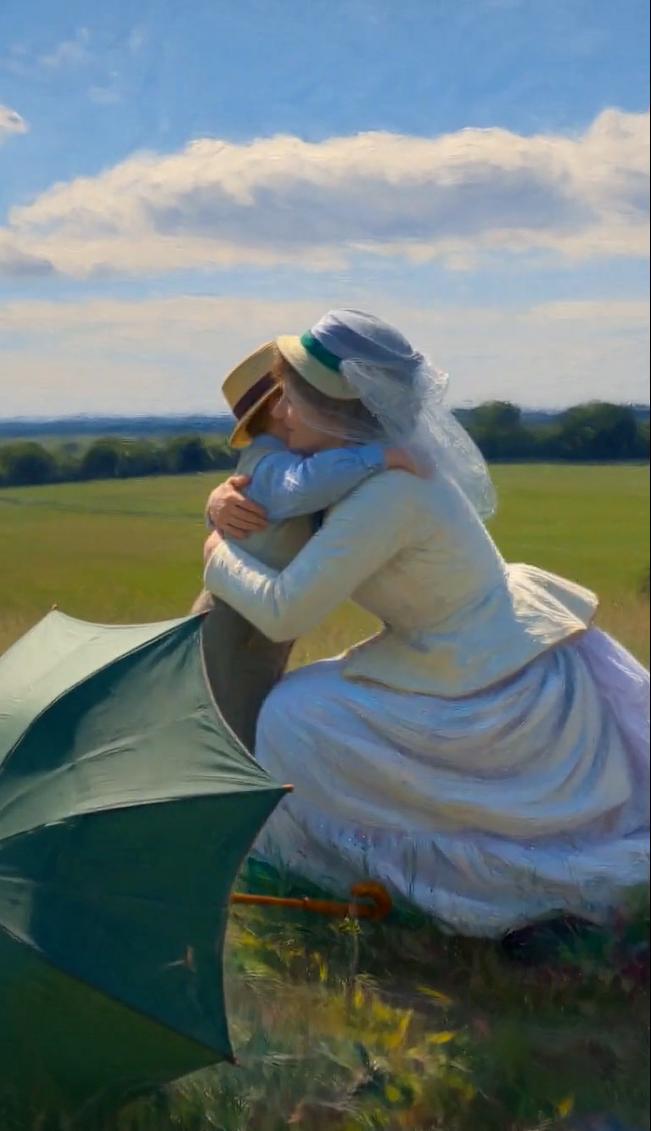
15秒一次生成,没剪没修。
下面把提示词和制作过程都分享出来,都是踩过坑之后总结的,拿去用,至少能少废三四条。
01 让油画动起来
1. 戴珍珠耳环的少女
第一个做得简单一点,机位是固定角度的,全部动作都在一个角度完成,同时对打光也提了些要求。
输入提示词,选择"多模态参考",把原画传进去,不然AI不知道照着谁画,自动搜索可能容易选错原图。如果想给视频添加声音,还可以上传参考音频。
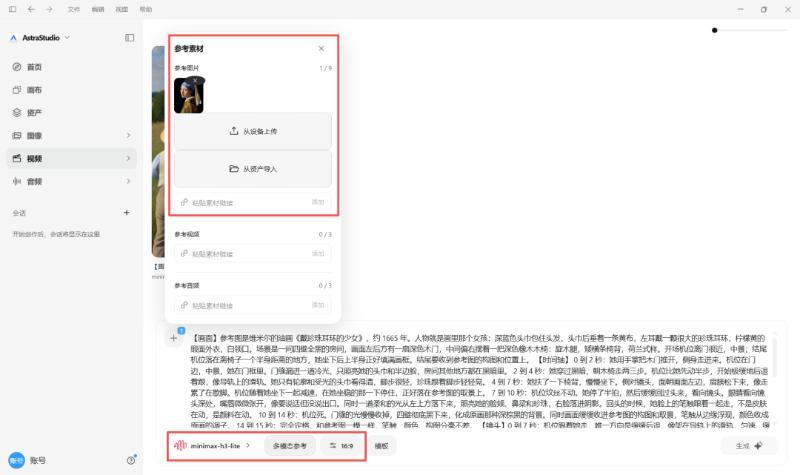
因为是固定机位,这个画面过渡不算很自然。想要更自然连贯的效果,提示词还是比较关键。可以发挥自己的想象,想让她怎么动,先自己想清楚,再让AI帮你写提示词。AI给的提示词自己多顺几遍再拿去生成,一次过的概率会高很多,不用反复生成消耗费用。
提示词:
<code class="language-text">【画面】参考图是维米尔的油画《<span>戴珍珠耳环的少女</span>》,约 1665 年。人物就是画里那个女孩:深蓝色头巾包住头发,头巾后垂着一条黄布,左耳戴一颗很大的珍珠耳环,柠檬黄的缎面外衣,白领口。场景是一间四壁全黑的房间,画面左后方有一扇深色木门,中间偏右摆着一把深色橡木木椅:旋木腿,矮横条椅背,荷兰式样。开场机位离门很近,中景;结尾机位落在离椅子一个半身距离的地方,她坐下后上半身正好填满画框。结尾要收到参考图的构图和位置上。【时间轴】0 到 2 秒:她用手掌把木门推开,侧身走进来。机位在门边,中景,她在门框里。门缝漏进一道冷光,只照亮她的头巾和半边脸,房间其他地方都在黑暗里。2 到 4 秒:她穿过黑暗,朝木椅走两三步。机位比她先动半步,开始极缓地后退着跟,像导轨上的滑轨。她只有轮廓和受光的头巾看得清,脚步很轻,珍珠跟着脚步轻轻晃。4 到 7 秒:她扶了一下椅背,慢慢坐下。侧对镜头,面朝画面左边,肩膀松下来,像走累了在歇脚。机位随着她坐下一起减速,在她坐稳的那一下停住,正好落在参考图的取景上。7 到 10 秒:机位纹丝不动。她停了半拍,然后缓缓回过头来,看向镜头。眼睛看向镜头深处,嘴唇微微张开,像要说话但没说出口。同时一道柔和的光从左上方落下来,照亮她的脸颊、鼻梁和珍珠,右脸落进阴影。回头的时候,她脸上的笔触跟着一起走,不是皮肤在动,是颜料在动。10 到 14 秒:机位死。门缝的光慢慢收掉,四壁彻底黑下来,化成原画那种深棕黑的背景。同时画面缓缓收进参考图的构图和取景,笔触从边缘浮现,颜色收成原画的调子。14 到 15 秒:完全定格。和参考图一模一样,笔触、颜色、构图分毫不差。【镜头】0 到 7 秒:机位跟着她走,唯一方向是缓缓后退,像架在导轨上的滑轨,匀速、缓入缓出,比她的脚步慢半拍,一次退到位。4 到 7 秒她坐下时,机位一起减速,她坐稳的那一帧机位停死。7 秒之后:机位完全静止,不推、不拉、不摇、不移、不变焦,直到结束。全程一个镜头,不切。【光线】全片只有两处光。开场是门缝漏进的一道冷光,照亮她进门。她坐下回头时,换成维米尔式的单一柔光,从左上方照下来,照亮她的脸颊、鼻梁和珍珠,右脸落进阴影。门缝光收掉之后,黑墙变成画里那种深棕黑的背景,柔光的方向不变,强度微收。 【质感】全程是油画,每一帧都是一幅画。厚涂的颜料、看得见的笔触、画布的颗粒、颜料干裂的细纹。黑暗的地方也要有笔触,是深棕黑的油彩,不是实心的黑幕。绝对不能变成实拍,不能出现真实的皮肤毛孔、发丝、布料织纹和镜头景深。她走动和回头的时候,颜料跟着流动,像湿的油彩被笔拖着走。 【禁止】不要改变她的脸型、五官、头巾、衣服和配色。不要手持晃动感,不要呼吸感运镜。镜头后退过程中不要变方向,不要中途加速或停顿,停住之后不要再有任何移动。门和椅子保持深色简单,不要加雕花,不要加任何原画里没有的东西:不要烛台,不要桌子,不要地毯,不要挂画,不要画框。不要出现文字和水印。不要把笔触磨平。不要提亮,不要锐化,不要加胶片颗粒。不要让脸变形。她回头的时候只转头,肩膀和身体不要跟着转。不要给手部特写,手宁可糊一点。
</code>
2. 撑阳伞的女人
有了第一个的经验,第二个就把提示词润色优化了一下。
这次让它有机位变动,不同时间段换不同运镜角度,复杂一点。每段提示词要把运镜角度写清楚,不然它会乱跑。
<code class="language-text">【画面】参考图是莫奈的油画《撑阳伞的女人》,1875 年。一个女人撑着绿色阳伞站在长满野草的山坡上,浅色长裙,头上戴着面纱,裙摆被风吹起。参考图只用来锁定这两个人的长相、衣服和配色。开场时她蹲在草里,张开双臂;一个戴草帽的小男孩从山坡上朝她跑过来。一把撑开的绿伞斜插在她蹲的位置旁边的草地上。结尾要收到参考图的构图、人物位置和大小上。【时间轴】0 到 2 秒:镜头在男孩背后,略低,拍男孩跑下草坡的背影,和他前方的女人:她蹲在草里,面对男孩的方向,张开双臂等他跑过来。风在吹,草叶往右倒,她的裙角贴着草轻轻动。笔触比原画松,像一幅还没画完的油画。2 到 4 秒:男孩跑到位,扑进她怀里,她把他搂紧,脸埋在他的小肩膀上。镜头同时沿一条弧线缓移到两人的侧面,变成侧面视角,拍这一对相拥的人。4 到 6 秒:拥抱结束,两人松开。镜头继续朝同一个方向缓移,弧线走完最后一段,停在女人背后,画面变成她的背影。男孩在她前方几步,面朝她站着。6 到 9 秒:女人转身走向身边那把绿伞,握住伞柄,把伞提起来,撑着慢慢站起来。机位比她先动半拍,极缓地向上抬一点,抬的幅度明显小于她起身的幅度。男孩拥抱后就站在原地,一步都没有动。9 到 11 秒:她站直,把伞靠上肩膀,停了半拍,然后转身,面对镜头。这时男孩已经在她身后几步远的草坡上,正是画里人物的大小和位置。11 到 14 秒:风变大。草浪从左往右一层层推过山坡,裙摆和面纱被吹得更开,几缕头发被吹乱,云缓慢右移,草地上的光斑扫过山坡。同时镜头缓缓向后拉远、微微上升,稳稳落到参考图的构图、角度和人物大小上。然后风力减弱,草浪一层层收住,伏倒的草重新立起,裙摆和面纱落回原位,笔触变厚、变清楚。14 到 15 秒:全部静止。和参考图一模一样,笔触、颜色、构图分毫不差。【镜头】0 到 6 秒:镜头沿一条弧线朝一个方向缓移,像绕着两个人走半圈:从男孩背后,到他们侧面,再到女人背后。匀速、缓入缓出,比男孩的奔跑慢半拍,中途不反向、不停顿、不切镜头。6 到 9 秒:机位随她起身极缓上抬,幅度小于她的动作,其余方向不动。11 到 14 秒:机位缓缓向后拉远,同时微微上升,一次走完,稳稳落在参考图的取景上,然后锁死。全程像架在稳定器上,不要手持晃动,不要呼吸感运镜,不要变焦感,不要追着人头摇。【光线】午后阳光从右上方斜射,逆光在女人的头发、肩膀和伞边勾出一圈金色轮廓光,男孩跑动时草帽下也有同样的受光。草地上有云的影子。光的方向、角度、强度全程不变,只允许光斑的位置随云移动。【质感】全程是油画,每一帧都是一幅画。短促的碎笔触、堆叠的厚颜料、画布经纬的颗粒。草是一笔一笔画出来的,不是一根根真草。云是旋转的色块,不是真实的水汽。绝对不能变成实拍,不要出现真实的草叶细节、布料织纹、皮肤质感和镜头景深。前段笔触可以松,后段要比原画更实。【禁止】不要给女人加五官细节,原画里那张脸是模糊的,始终保持模糊。不要加表情变化。男孩拥抱后就站着不动,不要蹲下,不要站起来,不要让他再跑动,不要让他走近或走远。不要给手部特写,手宁可糊一点。不要让她一边站起来一边转身,先站直,停一下,再转身。镜头不要中途反向,不要中途回落,不要重复绕圈。不要改变人物的位置、阳伞角度、山坡轮廓和颜色关系。不要加原画里没有的东西,不要加飞鸟,不要加远处的房子。不要出现画框。不要出现文字和水印。不要把笔触磨平。不要提亮,不要锐化,不要加胶片颗粒。
</code>
这一条的效果就比上一个丰富不少,也更接近大家在看的那种AI油画视频。
02 为什么这两段提示词能出好效果?
很多人直接抄提示词,但不知道为什么这么写。下面把踩坑后总结出来的几个关键点说一下,改的时候心里有数。
① 为什么要分【画面】【时间轴】【镜头】【光线】【质感】【禁止】六个模块?
AI文生视频模型是"多条件混合"的。只说"让她动起来",它会自由发挥,结果就是人物变形、背景乱加。把画面、动作、运镜、光线、质感分开写详细,相当于给AI发了一份分镜脚本,每个维度都明确约束,它就不会在没提的地方乱加戏。
② 为什么一定要写"结尾收到参考图的构图和位置上"?
这是最关键的一句。AI生成的视频如果没有"收束",最后一帧会飘走,人物位置、比例、构图都跟原画对不上,看起来就不像"那幅画动起来了",而像"从那幅画开始演了一段戏"。加上这句之后,视频的逻辑变成从原画出发,动一段,最后回到原画,观众的感受就是"这幅画活了",而不是"拿这幅画当开头"。
③ 为什么【禁止】列表比【要求】列表还长?
AI有"补全本能",没说的地方,它就会按自己的训练数据自动填上。只说"房间里有一把椅子",它可能顺手加个烛台、加张桌子、加扇窗户,加一堆乱七八糟的东西。【禁止】要求就是提前把这些"AI爱加但你不想要"的东西全部挡掉。每一条禁止,基本都是踩过的坑,比如"不要手部特写"是因为手一特写就变形,"不要呼吸感运镜"是因为AI默认会加手抖效果,"不要笔触磨平"是因为它总觉得"高清=好看"。
④ 为什么要强调"笔触跟着动,不是皮肤在动"?
这是"油画感"和"真人扮演"的分界线。如果只说"她转过头来",AI会按真人视频来生成。皮肤在动、肌肉在动、头发丝在动,出来就跟一个戴头巾的真人转头没区别。但加上"颜料跟着流动,像湿的油彩被笔拖着走",AI就会理解,动的是笔触本身,是颜料的形变,不是人体的运动。这一句决定了视频看起来是"一幅画在动",还是"一个人在演"。
⑤ 为什么运镜要写"比她的脚步慢半拍"?
这是电影语言里的"缓入缓出"。如果运镜速度跟人物动作完全同步,画面会显得很急,像在追着人跑。慢半拍的意思是,人物先动,镜头再跟上;人物停了,镜头再慢慢停。这种"滞后感"会让画面看起来很稳、很优雅,符合古典油画那种静谧的气质。AI默认的运镜通常是"匀速跟拍",写清楚这个"半拍差",质感立刻就上来了。
⑥ 想做30秒甚至更长的视频怎么办?
上面两个案例都是15秒,这是当前模型单次生成的标准时长。如果想做30秒的,核心方法就两个,增加剧情节点,拉长提示词的时间轴。
15秒的视频可能只有"进门、坐下、回头"三四个动作节点。30秒的话,需要把动作拆得更细,比如"推门、站定环顾、走到椅边、坐下、停顿、回头、再低头",中间多加一两个情节转折,让画面有"故事感"而不只是"动一下"。
对应的,提示词的【时间轴】也要按秒数拆得更细,每2到3秒写清楚,人物在做什么、镜头怎么动、光线有没有变化、笔触是什么状态。时间轴越长,提示词总字数就要越多,不然AI在长时间段里容易"走神",后半段开始乱加东西、人物位置飘走、笔触突然变实拍。
简单说,多长的视频,就配多长的提示词;多复杂的剧情,就拆多细的时间轴。15秒的提示词大概1000字左右,30秒的话建议写到1800到2000字,每个时间节点都不能省。
03 用什么做的
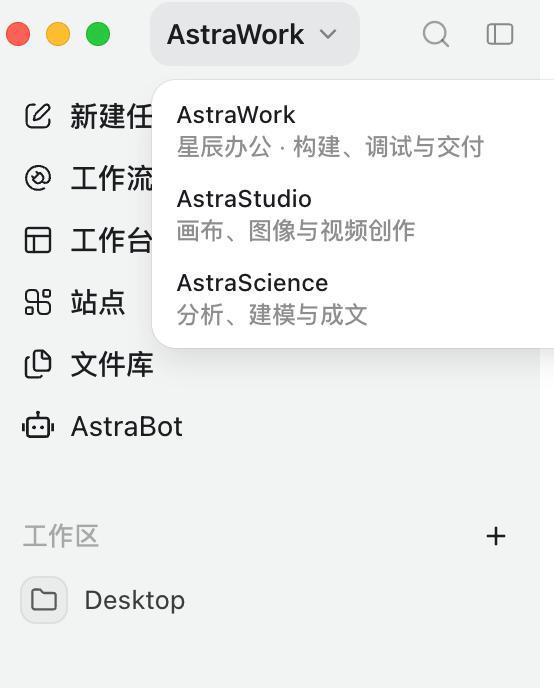
这次用的是UCloud优刻得的AstraWork去生成,左上角切换成AstraStudio就能进行专门的创意创作,可以选择文生视频或各种参考模式,在视频板块选择要用的模型和模式就行。
模型选了minimax-h3-lite,它比较"听话",提示词写清楚了,它就不会乱加东西,出来的画面也稳一些。
还有其他模型,比如HappyHorse、Kling,都可以试一试。
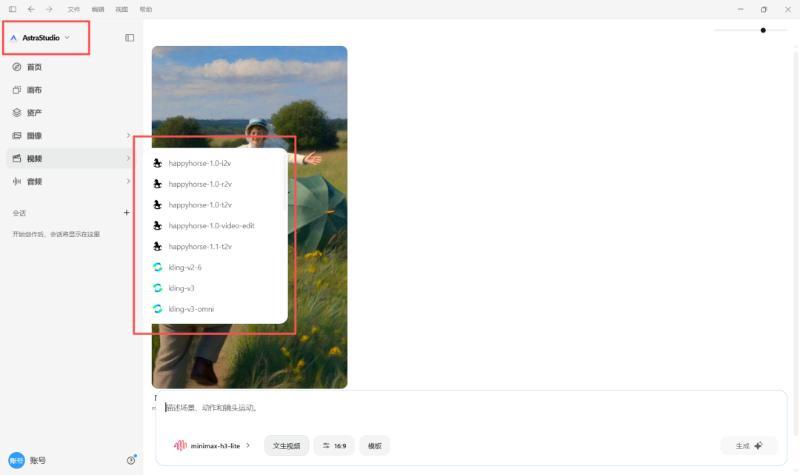
比如当想设计出30S的视频的时候,就可以通过增加剧情节点、拉长时间轴来操作。
04 AI油画难做吗?
AI油画视频制作起来并不难,而且生成了3条视频也就花了13块(不算前面废的那五六条)。主要是要想好想要什么样的画面。
自己写或让AI写提示词都行,写详细点,就不用反复修改提示词、反复重新生成。
上面的提示词可以直接用,也可以改改里面的细节,生成自己想要的版本。
FAQ
Q1:AI油画视频一般多长?
当前模型单次生成的标准时长是15秒。想做30秒需要增加剧情节点并拉长提示词时间轴,30秒建议写到1800到2000字。
Q2:为什么AI生成的油画人物脸会变形?
没有上传参考图时,AI会自动搜索原图,可能选错。选择"多模态参考"并上传原画,同时在【禁止】中写明"不要改变脸型、五官",可以大幅降低变形概率。
Q3:生成一条AI油画视频大概多少钱?
用UCloud优刻得AstraStudio的minimax-h3-lite模型,3条视频花费约13元,单条约4到5元。前期废片成本另计,踩坑阶段废了五六条,花了小二十块。
Q4:提示词要写多长?
15秒视频的提示词约1000字,30秒建议1800到2000字。时间轴越长,提示词总字数就要越多,否则AI在长时间段里容易"走神"。
Q5:除了minimax-h3-lite还有什么模型可选?
AstraStudio还提供HappyHorse、Kling等模型,可以根据具体需求选择。minimax-h3-lite的特点是"听话",提示词写清楚就不会乱加东西。