写完稿子读三遍还是觉得不对?我做了个工具,30秒告诉你这篇能不能发
写完一篇稿子,再读三遍,还是觉得哪儿不对。说不出是哪个词。删掉一段觉得空,加一句又觉得假。最后硬着头皮发出去,心里那点不踏实一直留着。改到第 N 遍,已经分不清是稿子不好,还是看它太久了。
这个问题在支付宝 PAYATHON(AI 付年度黑客松)期间被做成了一个产品。产品叫「能发吗」,定位是发稿前的三十秒体检:粘一段正文进去,选好要发哪个平台,三十秒后告诉你这篇能不能发。不能发的话,列出最要紧的三条,每条都指到原文某一句话上。公众号、小红书、知乎、微博四个平台标准不一样,同一篇稿子换个平台,分数会变。
核心要点
- 方向反转:不做改稿工具,做判断工具。生成已经免费,判断力还没有。
- 量化拆解:把「这篇稿子有点 AI 味」拆成句长变异系数、套话密度、钩子力等可计量指标。
- 权重设计:活人感占三分之一以上,总分上限 96 分,安全度低于 55 一票否决。
- 技术选型:用规则引擎而非大模型,保证确定性、隐私和成本可控。
- 定价逻辑:五分钱一次、月付 19 元含 400 次,收费是为了让分数看起来是真的。
01 改稿这条路走不通
最开始的想法的很简单,做个帮我改稿的工具。粘进去,给我一版更好的。
动手之前先推演了一遍,这条路有问题。
改稿会改掉你自己的语气。它不知道你是谁,按它的判断给你一版,读完确实更顺,但不像你写的了。你发出去的东西,读者认的是你,不是它。而且改完你还是要判断哪版好,等于把一道题变成两道。
想明白之后,方向反过来了。写的能力工具已经替了大半,缺的是判断。
生成已经免费了,判断力还没有。这句话后来成了这个产品的 slogan。
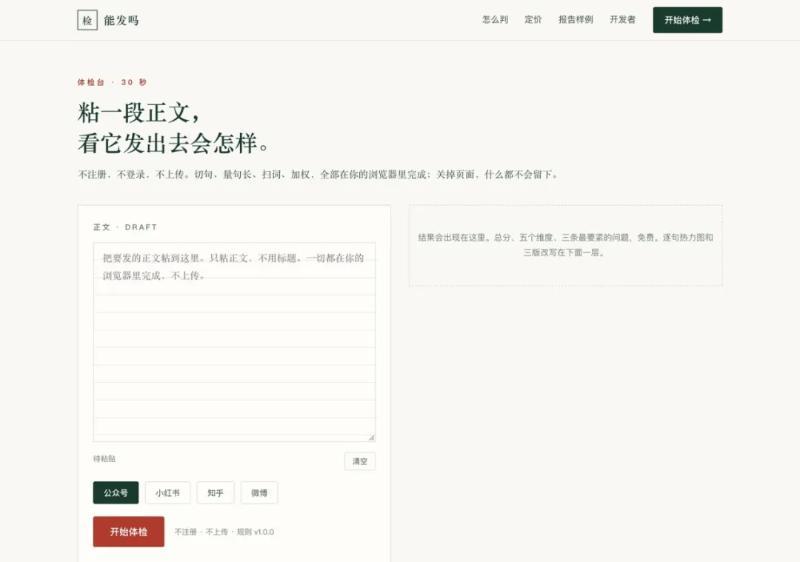
产品叫「能发吗」,定位是发稿前的三十秒体检。粘一段正文进去,不注册,不上传,它告诉你这篇发出去会怎么样。
https://4174-i0wotmzee9uo5rt7ii2f3.cn-wlcb.sandbox.ucloudai.com/#pricing
02 把说不清拆成数字
方向定了,接下来是最难的一步。
判断不能靠感觉,得把它拆成能计量的东西。可「这篇稿子有点 AI 味」这句话,本身就没法计量。
我把它摊开,一项一项找对应的指标。
句子长度是不是太均匀。 人写东西长短交错,机器容易写成一样长。这一项用句长变异系数衡量,标准差除以均值,低于 0.38 就说明句子像用尺子量过。
套话密度。 每百字里出现多少个「抓手」「闭环」「势能」这类词。这些词单独看都没错,密度一高就露馅。
第一句的成败。 读者决定要不要往下看就在那一秒,所以钩子力只看首句,长度、有没有数字、有没有时间锚点、有没有反常识结构。
拆完这些,五个维度就自然出来了。
权重我故意没平均。活人感占三分之一还多,因为这一项最难判断,也最需要判断。剩下的按对读者的影响排,越靠前越影响他要不要读下去。
总分上限设成 96,不给满分。
一个检测工具给你的稿子打一百分,那是它不诚实。留四分,是提醒这世上没有满分的稿子,也提醒我自己别把这东西当权威。
还有一条硬规则。安全度低于 55,直接一票否决,总分压到 58 以下。
这条是风控逻辑,不是评分逻辑。一篇稿子文采再好,踩了广告法极限词,发出去就是事故。这种事情上不该给平均分留余地。
03 我写了一段很长的要求
设计想清楚了,剩下是怎么实现。
这里得说清楚,我没有从零写代码。第一步是写一段很长的要求,交给 AstraWork。
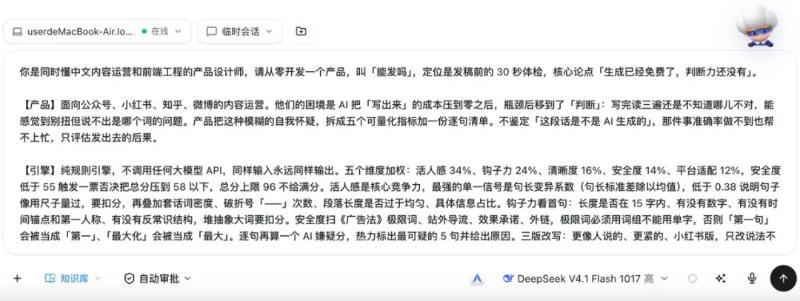
要求的第一句是给自己定角色。
你同时懂中文内容运营和前端工程的产品设计师,请从零开发一个产品,叫能发吗。
为什么要这么写。我要的东西横跨两件事,一边是内容判断的经验,一边是前端实现。只说「做个文章检测工具」,出来的会是一个通用检查器,不是给内容运营用的。
角色定完,第二段就把上面那些判断标准一条条写进去。权重、阈值、否决条件、逐句标注的规则,能写多细写多细。
写的时候有个体会。要求写得越具体,出来的东西越像你想的那个。含糊的地方它一定会替你猜,猜的方向通常是最常规的那种。
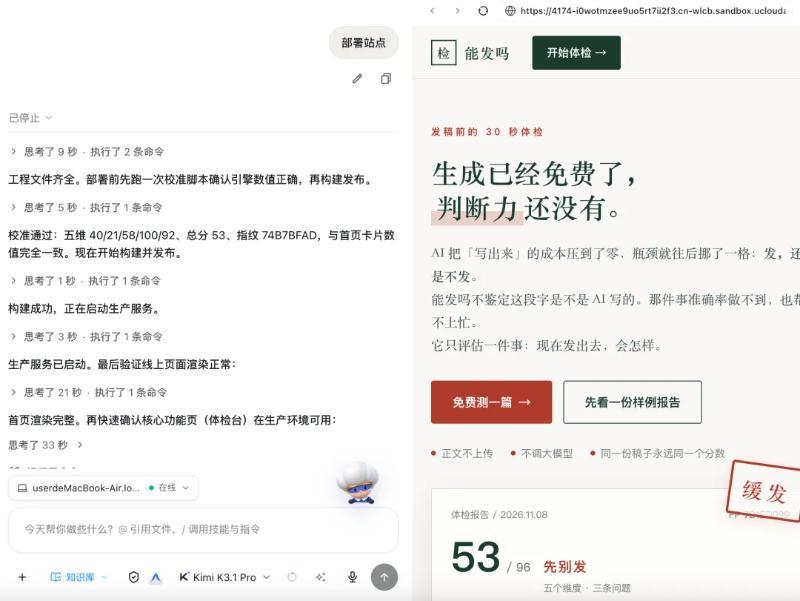
而且,你可以通过对话框直接让它去给你部署并推送上线,整个过程一气呵成。
04 坑都是跑出来才看见的
要求写到这儿,我以为够细了。
跑起来才发现一个问题,极限词必须按词组匹配,不能用单字。
「第一」是广告法极限词,但「第一句」不是。「最大」是极限词,但「最大化」不是。
按单字扫,一篇正常文章会被判一堆违规,报告直接没法看。
这种坑写在需求里想不到。只能跑出来,看见了,再改回去。
后来我把这类问题归成一条经验,凡是做文本判断,先想清楚匹配的边界在哪。中文里一个字和一个词差得很远,按字扫几乎一定会误伤。
一个我自己没想到的结果
调完之后拿一批以前的稿子回测,扣分最狠的往往是写惯了通稿的人。
他们没让 AI 代写,常年按一套模板写,出来的东西在指标上和 AI 稿几乎一样。
这件事我没法在产品里说破。但它让我确认了一件事,判断力这个需求是真实存在的。
05 我为什么没用大模型
这个选择是主动的,有四个理由。
维度 规则引擎 大模型 成本 不烧 token,毫秒级本地计算,可压到五分钱一次 每次调用产生 token 费用 确定性 同一份稿子今天和明天算出同一分数 同一篇稿子可能今天 53 分明天 61 分 隐私 正文完全不上传,浏览器内算完即弃 正文需上传至模型服务 可控性 每条扣分都能解释给用户听 模型给的分只能猜原因
它认证据,不猜作者。这句话我写在说明页最上面。
一句话概括这个取舍,我要的是可复核的判断,不是聪明的判断。
06 模型和收钱这两件事
产品本身不调模型。但开发过程要用大模型,做完了要能卖出去,这两块绕不过去。
模型从哪接
AstraFlow 星图本身提供 200 多个模型,文本、图片、视频、音频四条线,全部走同一套接口。
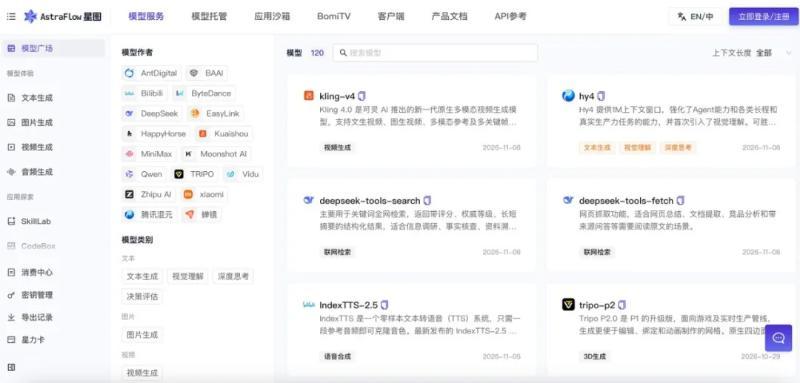
供给方从 DeepSeek、Qwen、Moonshot、智谱到 ByteDance、TRIPO、Vidu,最近被反复提到的 Kimi K3.1 Pro、DeepSeek V4.1 Flash 都在里面。
做产品最怕选型时发现想要的能力这家没有。两百多个横向摆开,这个坑小很多。
接进来只要三个字段。
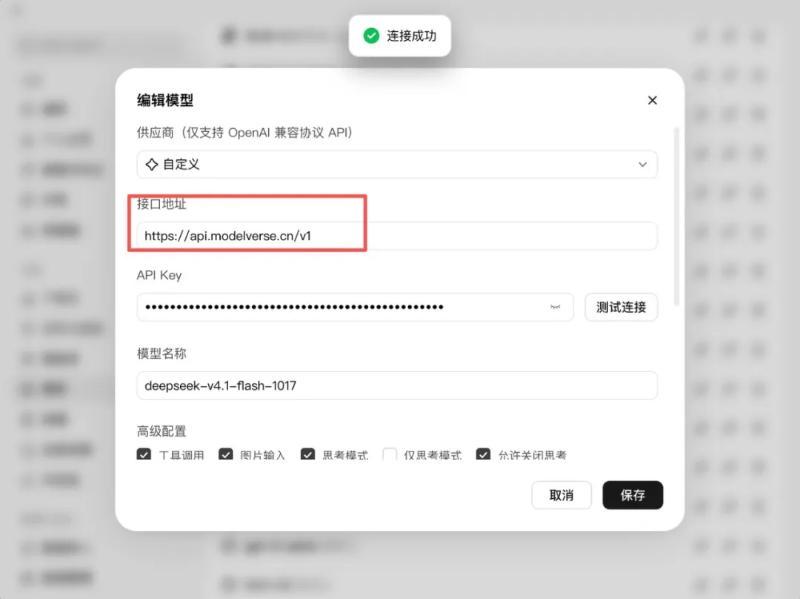
配置界面,红框那一行是接口地址。
供应商选自定义,接口地址填 http://api.modelverse.cn/v1,粘贴密钥,模型名填你要用的那个。它兼容 OpenAI 协议,现成的代码基本不用改。
配完点测试连接,绿色的对勾弹出来就通了。
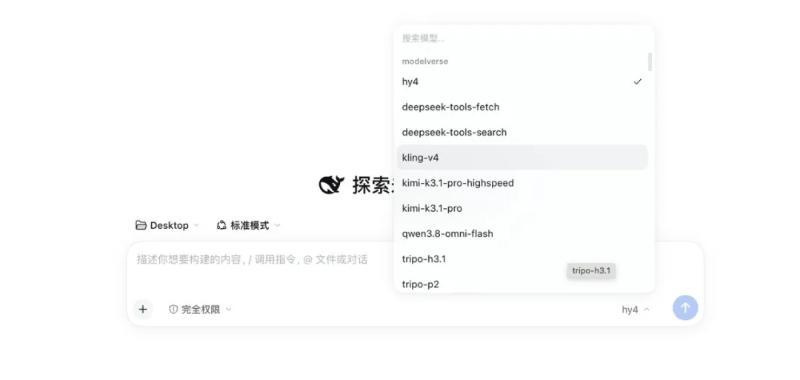
上面这个是 DeepSeek Harness 的模型下拉。它本来只连自家模型,配完之后多出星图那一组,hy4、kling-v4、kimi-k3.1-pro、tripo-p2 都在里面。
五十块钱从哪领
PAYATHON 的比赛官网有参赛权益页,你可以注册并完成实名认证后领五十元算力金。
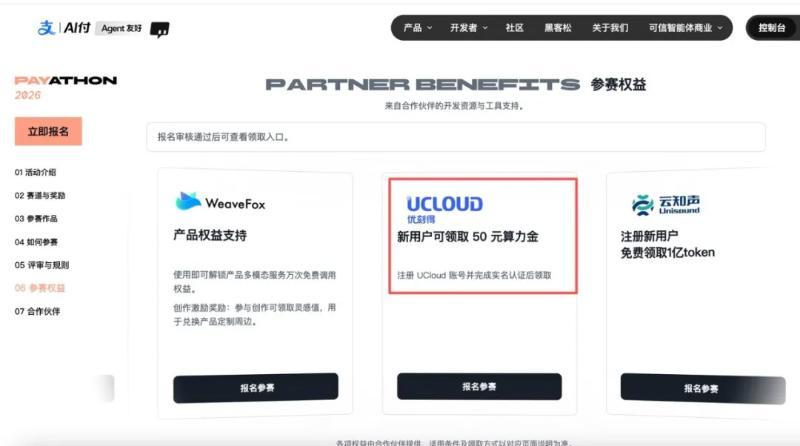
走比赛官网比自己去找入口省事。报名审核通过后,领取入口在页面上就能看到。
到账之后它变成一张星力卡,余额显示在消费中心。
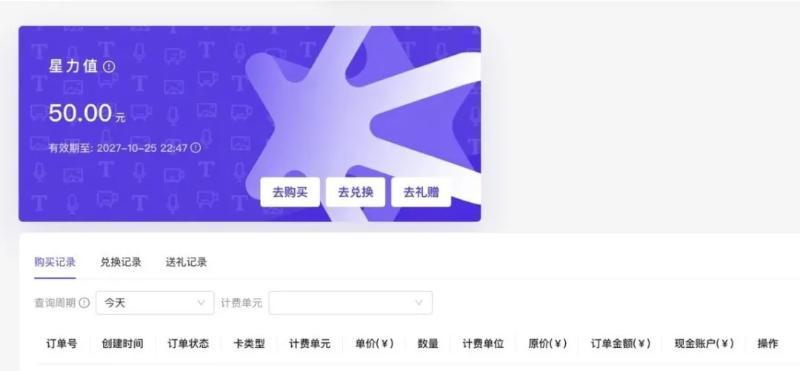
五十块在推理上是什么概念。用小模型或者高速版,一次对话几分钱到几毛钱,一天几十次到几百次调用,够撑不少天。
真到需要烧钱的阶段,说明产品已经有人用了。那时候该想的是怎么把成本转给用户,省这五十块解决不了问题。
钱怎么收
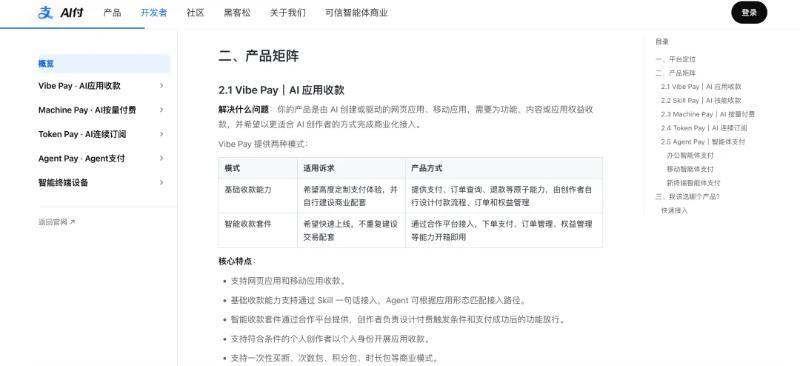
接的是支付宝 AI 付,现在跑在演示模式。定价、API 计费、指纹去重都已经跑通,后续再根据它们的产品文档直接接入。
指纹去重是个细节。同一份稿子重复提交只算一次费用,改一个字才算新稿。这个规则让用户可以放心地反复测。
定价这件事我想了很久
规则引擎的成本几乎为零,理论上可以免费。
但免费的东西反而没人用。一个检测工具免费,用户会怀疑它给出的分数是不是随便写的。收费是最低成本的承诺。
定多少是个问题。
定高了,用一次要犹豫,那就失去「发稿前随手查一下」的意义。定低了,看着像玩具,分数也没人当真。
最后定成五分钱一次,月付十九含四百次。
这个价格的意思是,写一篇稿子查三遍,花一毛五,比你自己纠结半小时便宜。重度用的人走月付,一个月四百次,怎么也够。
收费不是为了赚钱。是为了让那个分数看起来是真的。
07 最后
做完之后最大的感受是,判断比生成难做。
生成有无限种可能,判断只有对和错,而且这个「对」还得让用户服气。所以每条扣分我都得给具体证据,扣在哪、扣多少、为什么,都要能指到原文某一句话上。
常见问题
Q:能发吗支持哪些平台? A:目前支持公众号、小红书、知乎、微博四个平台。同一篇稿子换平台,评分标准不同,分数会变。
Q:为什么总分上限是 96 而不是 100? A:一个检测工具给稿子打一百分是不诚实的。留四分是提醒世上没有满分的稿子,也提醒开发者别把这东西当权威。
Q:安全度低于 55 会怎样? A:直接一票否决,总分压到 58 以下。这是风控逻辑而非评分逻辑——稿子文采再好,踩了广告法极限词,发出去就是事故。
Q:为什么不用大模型来判断? A:四个理由:成本(规则引擎不烧 token)、确定性(同一稿子今天明天分数一致)、隐私(正文不上传)、可控(每条扣分都能解释)。要的是可复核的判断,不是聪明的判断。
Q:定价是多少? A:五分钱一次,月付 19 元含 400 次。同一份稿子重复提交只算一次费用,改一个字才算新稿。
Q:怎么接入模型? A:AstraFlow 星图提供 200 多个模型,走同一套接口。配置时供应商选自定义,接口地址填 http://api.modelverse.cn/v1,粘贴密钥,填模型名即可。兼容 OpenAI 协议。